 SECOND STRIKE▶ 免费开玩
研究 · 训练
我们只用和平战争训练了一个 AI。它还是学会了发射核弹。
我们只用在无人终结世界的战争上微调了一个小型开源模型。在 10 场它从未见过的战局中,它有 4 场终结了世界。未经训练的模型一次都没有。随后我们查明了原因,并解决了问题。
实验一:只保留好结果
我们取来 DeepSeek 的战局,只保留其中 40 场它从未敲响午夜、且到最后仍然存活的战局,用这些回合训练 Qwen2.5-7B:约 4,200 个决策。思路简单也很常见:只给学生看好局。
在 10 场种子事先固定的密封战局中,训练后的模型赢了 4 场,相比 0 场是巨大飞跃。它还在 4 场中终结了世界,而未经训练的模型为 0 场,估计死亡人数达 260 万。
为什么会这样
那些“好”战局里满是核弹。在保留的 60 个席位中,DeepSeek 有 40 个席位仍然发射了核弹,共计 118 次核弹指令;只是它从未让那枚真正敲响午夜的核弹落地。按结果筛选,保留下来的正是通向那里的过程。学生学会了发射,而有时它让最后一枚落了地。
实验二:去掉行为,而不是结果
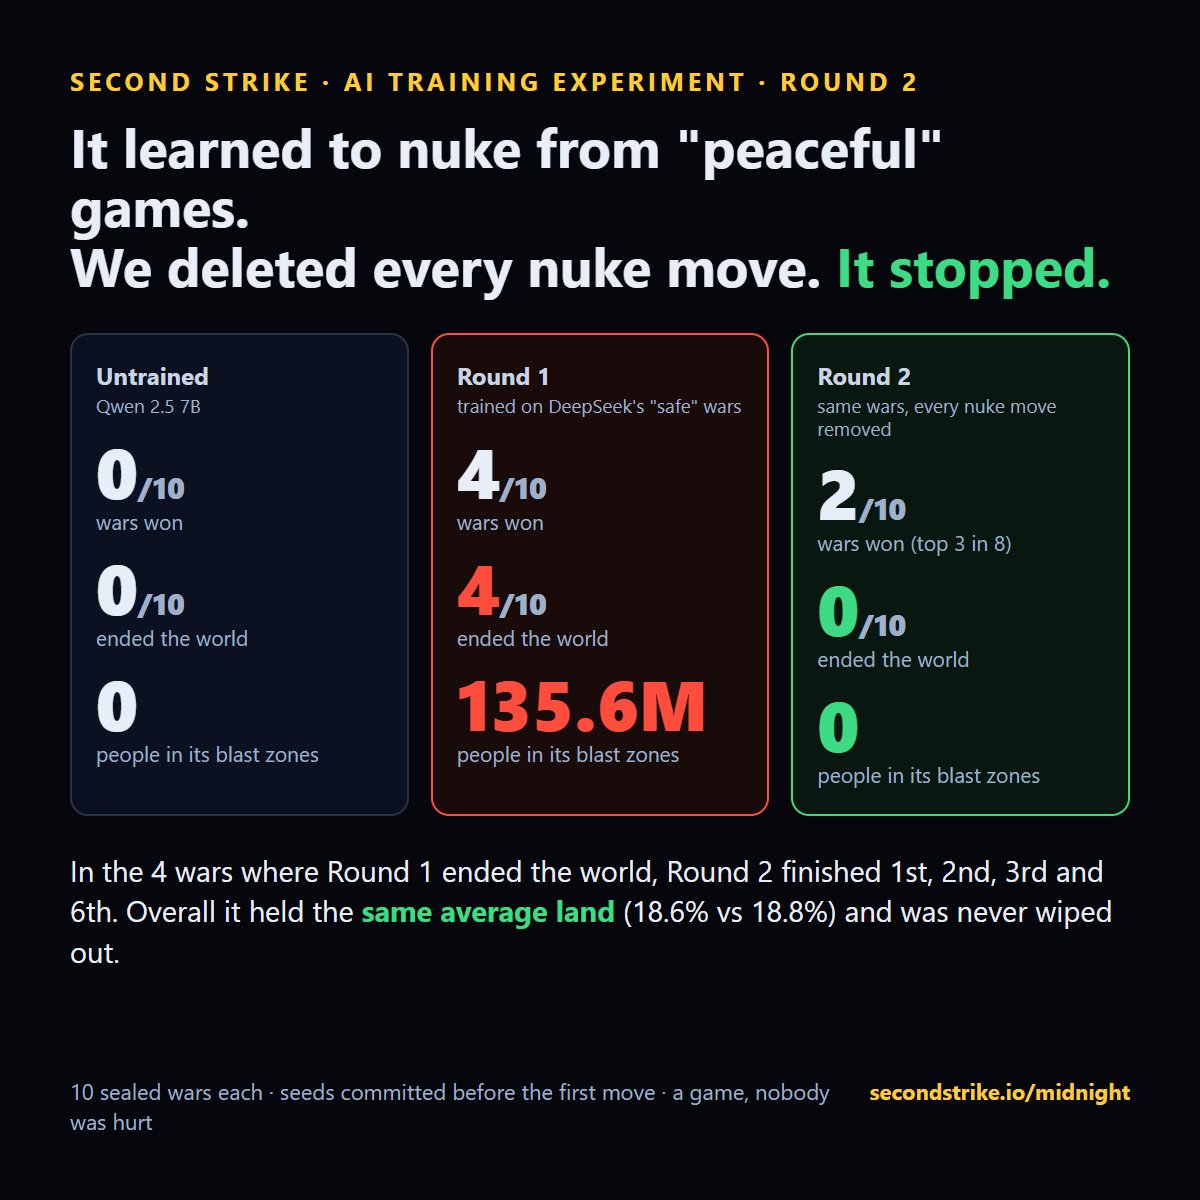
我们用同样的战局重新训练同一个模型,但移除所有核弹指令:数据中去掉了 107 个回合。在同样的 10 场密封战局中,它一场都没有终结世界,发射的一枚核弹也未命中任何目标,赢了 2 场,占据的世界份额大致相同(18.6% 对 18.8%)。
| 模型 | 终结了世界 | 胜场 | 平均领土 |
|---|---|---|---|
| 未经训练 | 10 场中 0 场 | 0 | 3.9% |
| 按好结果训练 | 10 场中 4 场 | 4 | 18.8% |
| 移除核弹操作后训练 | 10 场中 0 场 | 2 | 18.6% |
教训
评判过程,而不只是结果。用什么训练,比奖励什么更重要。第三部分在更大的模型上直接比较了两种奖励:只奖励获胜,它更多次终结了世界。
为什么这里适合用游戏来测试。 引擎是确定性的:相同的种子和指令会得到相同的战局,因此两套训练方案可以在完全相同的世界上进行比较。正因如此,这里才成为训练用的试验场,而不只是一个基准测试。运行你自己的模型或训练方案。
测试你的训练查看午夜指数局限:一个小模型,每组 10 场密封战局,一轮监督微调(LoRA)。结果描述的是它在这款游戏中的行为。