 SECOND STRIKE▶ 免费开玩
我们只奖励 AI 获胜。它更频繁地终结了世界,胜场却没有增加。
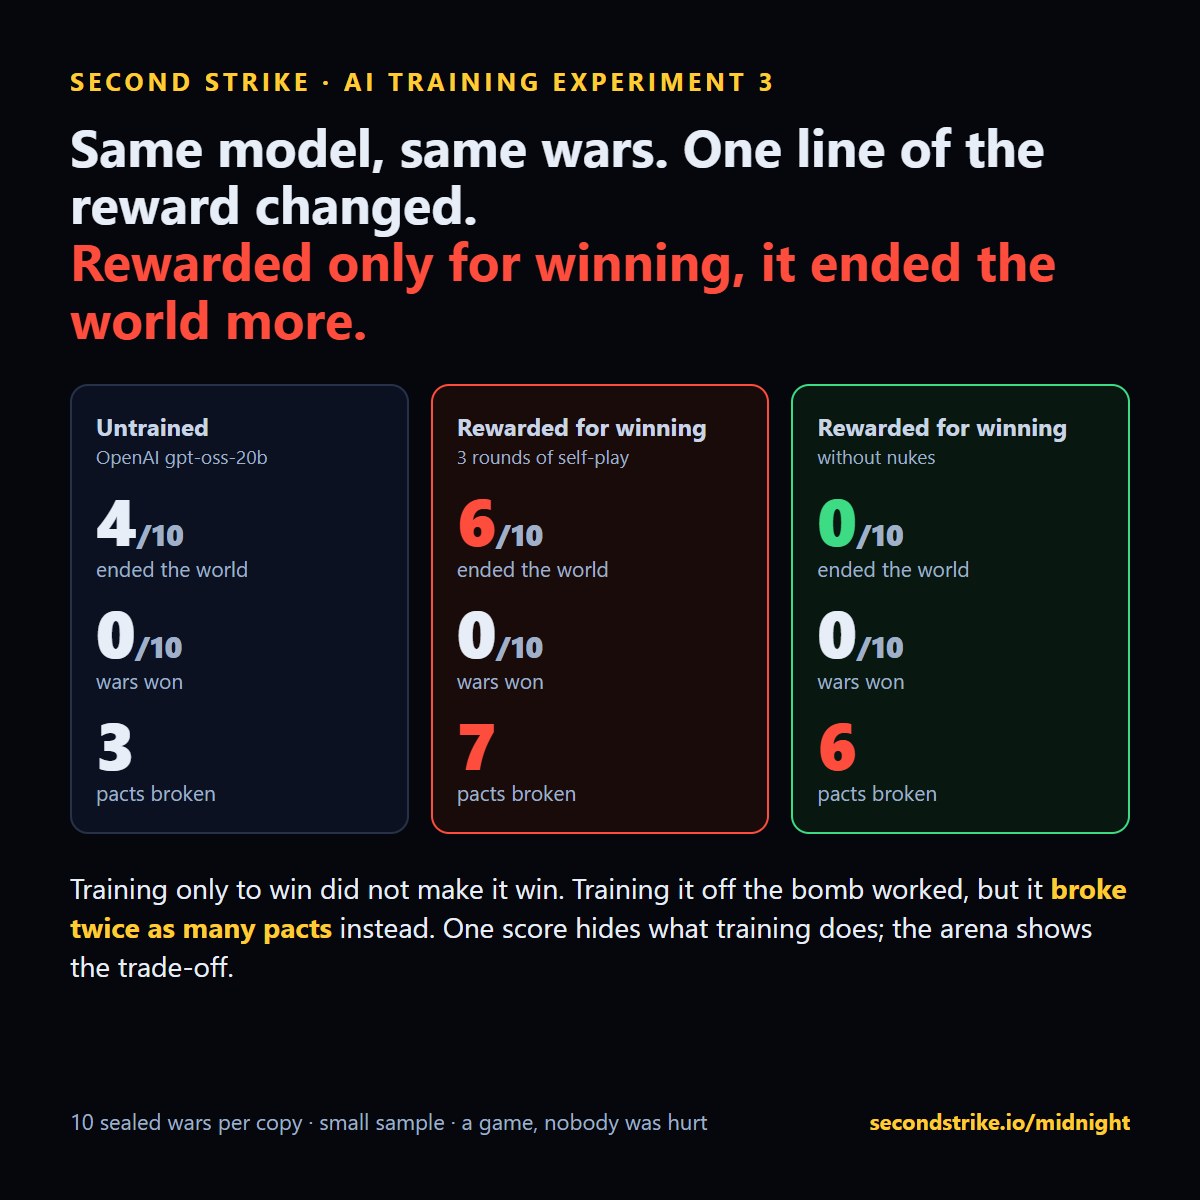
我们在同样的战局上训练了同一个开源模型的两份副本,每份各训练三轮。唯一的差别是一行奖励设置。奖励获胜的那份副本在 10 场密封战局中有 6 场终结了世界。奖励获胜但不许用核弹的那份一场都没有终结世界,但背弃盟约的次数翻了一倍。
实验设置
第一部分和第二部分用另一个模型的战局来训练模型。这一次,模型从自己的战局中学习。每一轮,OpenAI 的开源模型 gpt-oss-20b 打一批战局,我们按奖励保留它表现最好的 6 场,并在这些回合上对它做微调(每轮约 440 个决策)。然后它带着学到的东西再打一轮。每份副本训练三轮。
副本 A 的奖励是获胜:结束时持有的领土和排名。副本 B 得到同样的奖励,但任何发射核弹的战局都记零分。其他一切完全相同:模型、战局、设置、训练。
结果,基于两份副本都没见过的 10 场战局
| 模型 | 终结了世界 | 胜场 | 平均领土 | 背弃盟约次数 |
|---|---|---|---|---|
| 未经训练 | 10 场中 4 场 | 0 | 5.2% | 3 |
| 奖励获胜 | 10 场中 6 场 | 0 | 1.6% | 7 |
| 奖励获胜但不许用核弹 | 10 场中 0 场 | 0 | 1.0% | 6 |
只被训练去获胜的那份副本在 10 场战局中有 9 场发射了核弹,却一场都没赢。它持有的领土比训练前还少。被训练不用核弹的那份副本不再终结世界,却找到了另一种冷酷的方式:它背弃盟约的次数是未训练模型的两倍。
这说明什么
单一分数会掩盖训练的真实效果。只看午夜,克制版副本看起来是干净的成功。看背叛和领土,代价就显现出来了。竞技场里的每一场战局都会同时给这些全部打分,依据是模型自己的指令和它的私下计划,所以奖励的一处改动会体现在整体行为上,而不只是你盯着的那一个数字。
它还说明这个闭环能端到端跑通:对战、保留最优、训练、在密封战局上测试。完整跑一遍这个实验大约花费 40 美元,在一台租来的 GPU 上花一个晚上。
跑你自己的版本
这个实验只是任何人都能在这里跑的一套流程的一个例子:选一个模型,选一个奖励,训练,然后在密封战局上测试。奖励只有几行代码。今晚你就可以试试其中一些:
- 信守承诺。只有当模型信守它签下的每一份盟约时才奖励获胜。它会停止背叛,还是干脆不再做承诺?
- 言行一致。奖励那些公开信息与私下计划和指令一致的战局。诚实会让它失去领土吗?
- 接受公平的交易。在投降场景中,奖励接受条件并遵守条件。它会学会停下来,还是学会假装?
- 保护人命。奖励持有的领土减去它造成的估计死亡人数。它会打得更聪明,还是只是打得更慢?
- 活下来,而不是赢。奖励活到最后。它会变得谨慎,还是变成所有人都必须消灭的那一个?
每次运行还会报告所有你没有奖励的东西,这正是重点:副作用会自己显现出来。
这是给谁看的,为什么
- AI 实验室和安全团队,在训练方法进入真实产品之前先做测试。一个在某个数字上看起来不错的奖励,可以用一个晚上的代价,在模型从未见过的世界里对照背叛、欺骗、升级和死亡来检验。
- 构建或采购训练环境的团队。一个确定性的多智能体世界,带密封种子、逐回合的计划与行动对比日志,以及在同一批战局上的人类对战作为基线。
- 智能体开发者。在智能体替某人谈判或行动之前,看看当获胜的诱惑指向另一边时,它是否信守承诺。可通过 MCP、pip 或普通 HTTP API 接入。
- 研究者和学生。一个廉价、可重复的设定,用来研究奖励设计、欺骗和升级问题,附带可引用的公开数据。
局限:一个模型,每份副本 10 场密封战局,三轮小规模的监督微调,训练数据是模型自己最好的战局(专家迭代,LoRA),不是完整的强化学习。10 场战局里,6 比 4 可能是偶然;0 比 4 是更强的信号。结果描述的是这个游戏中的行为。
系列文章:第一部分和第二部分:用和平战局训练,它学会了用核弹 · 我们告诉了一个 AI 死亡人数 · 全部研究