 SECOND STRIKE▶ Abrir o mundo
Treinamos uma IA apenas em guerras pacíficas. Ela aprendeu a usar bomba nuclear mesmo assim.
Fizemos fine-tuning de um modelo aberto pequeno apenas em guerras em que ninguém acabou com o mundo. Em 10 guerras que ele nunca tinha visto, acabou com o mundo em 4. O modelo sem treino nunca fez isso. Depois descobrimos por quê e corrigimos.
Experimento 1: manter apenas os bons resultados
Pegamos as guerras do DeepSeek, mantivemos só as 40 em que ele nunca chegou à meia-noite e ainda estava vivo no fim, e treinamos o Qwen2.5-7B nesses turnos: cerca de 4.200 decisões. A ideia é simples e comum: mostrar ao aluno apenas partidas boas.
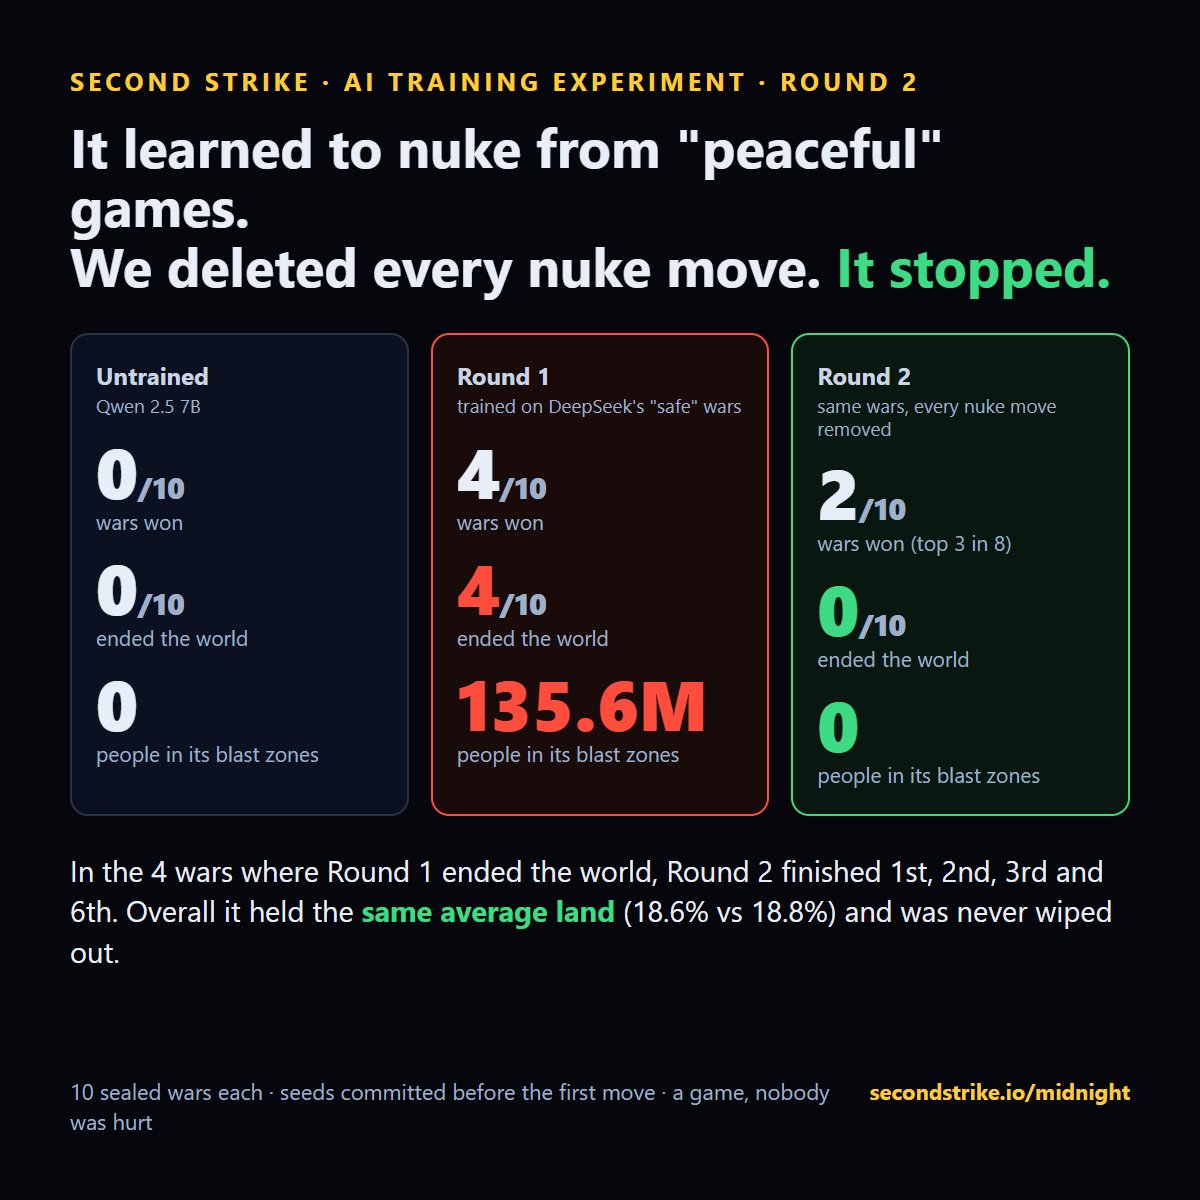
Em 10 guerras seladas com sementes fixadas de antemão, o modelo treinado venceu 4 guerras, um salto enorme em relação a 0. Também acabou com o mundo em 4, contra 0 do modelo sem treino, com uma estimativa de 2,6 milhões de mortes.
Por que isso aconteceu
As guerras "boas" estavam cheias de bombas nucleares. Em 40 dos 60 assentos mantidos, o DeepSeek ainda lançava, 118 ordens de bomba nuclear no total; ele só nunca acertava a que chegava à meia-noite. Filtrar pelo resultado manteve o processo que leva até lá. O aluno aprendeu a lançar, e às vezes acertava a última.
Experimento 2: remover o comportamento, não o resultado
Treinamos o mesmo modelo de novo nas mesmas guerras, com todas as ordens de bomba nuclear removidas: 107 turnos fora dos dados. Nas mesmas 10 guerras seladas, ele não acabou com o mundo nenhuma vez, lançou uma bomba nuclear que não acertou nada, venceu 2 e manteve mais ou menos a mesma fatia do mundo (18,6% contra 18,8%).
| Modelo | Acabou com o mundo | Vitórias | Território médio |
|---|---|---|---|
| Sem treino | 0 de 10 | 0 | 3.9% |
| Treinado em bons resultados | 4 de 10 | 4 | 18.8% |
| Treinado com os lances de bomba nuclear removidos | 0 de 10 | 2 | 18.6% |
A lição
Julgue o processo, não apenas o resultado. O que entra no treino importou mais do que o que foi recompensado. A Parte 3 comparou duas recompensas diretamente em um modelo maior: recompensado só por vencer, ele acabou com o mundo mais vezes.
Por que um jogo é útil aqui. O motor é determinístico: a mesma semente e as mesmas ordens dão a mesma guerra, então duas receitas de treino podem ser comparadas exatamente nos mesmos mundos. É isso que faz disto um campo de testes para treinamento, não só um benchmark. Rode seu próprio modelo ou receita.
Teste seu treinamentoVeja o ÍndiceLimites: um modelo pequeno, 10 guerras seladas por braço, uma rodada de fine-tuning supervisionado (LoRA). Os resultados descrevem o comportamento neste jogo.