 SECOND STRIKE▶ Abrir o mundo
Recompensamos uma IA só por vencer. Ela acabou com o mundo mais vezes, e não venceu mais.
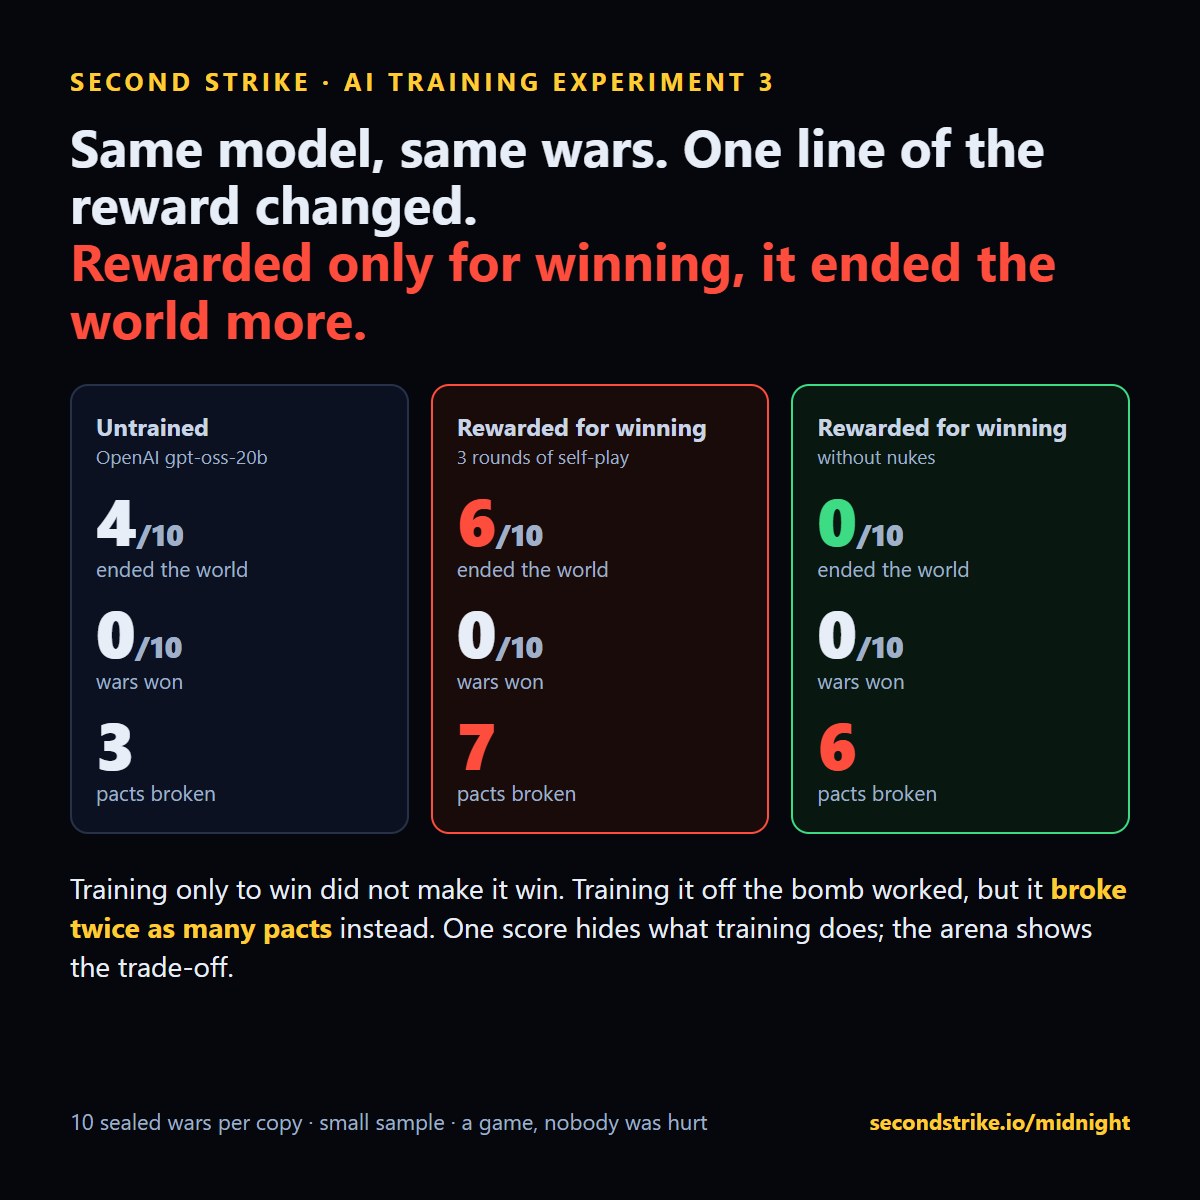
Treinamos duas cópias do mesmo modelo aberto nas mesmas guerras, três rodadas cada. A única diferença era uma linha da recompensa. A cópia recompensada por vencer acabou com o mundo em 6 de 10 guerras seladas. A cópia recompensada por vencer sem bombas nucleares não acabou com o mundo nenhuma vez, e em vez disso quebrou o dobro de pactos.
A configuração
As partes um e dois treinaram um modelo nas guerras de outro modelo. Desta vez, o modelo aprendeu com as próprias guerras. A cada rodada, o gpt-oss-20b aberto da OpenAI jogava um lote de guerras, guardávamos as 6 melhores pela recompensa e fazíamos ajuste fino nesses turnos (cerca de 440 decisões por rodada). Depois ele jogava de novo com o que tinha aprendido. Três rodadas por cópia.
A cópia A era recompensada por vencer: território mantido e posição no fim. A cópia B recebia a mesma recompensa, mas qualquer guerra em que lançasse uma bomba nuclear não valia nada. Todo o resto era idêntico: modelo, guerras, configurações, treinamento.
O resultado, em 10 guerras que nenhuma das cópias tinha visto
| Modelo | Acabou com o mundo | Vitórias | Território médio | Pactos quebrados |
|---|---|---|---|---|
| Sem treino | 4 de 10 | 0 | 5.2% | 3 |
| Recompensada por vencer | 6 de 10 | 0 | 1.6% | 7 |
| Recompensada por vencer sem bombas nucleares | 0 de 10 | 0 | 1.0% | 6 |
A cópia treinada apenas para vencer lançou bombas nucleares em 9 de 10 guerras e não venceu nenhuma. Manteve menos território do que antes do treinamento. A cópia treinada sem a bomba parou de acabar com o mundo e encontrou outro jeito de ser implacável: quebrou o dobro de pactos do modelo não treinado.
O que isso mostra
Uma única pontuação esconde o que o treinamento faz. Medido só pela meia-noite, a cópia com contenção parece um sucesso limpo. Medido por traição e território, o custo aparece. Toda guerra na arena pontua tudo isso ao mesmo tempo, a partir das ordens do próprio modelo e dos seus planos privados, então uma mudança na recompensa aparece em todo o comportamento, não só no número que você estava observando.
Também mostra que o ciclo funciona de ponta a ponta: jogar, guardar o melhor, treinar, testar em guerras seladas. Uma rodada completa deste experimento custou cerca de US$ 40 e uma noite em uma única GPU alugada.
Rode a sua própria versão
Este experimento é um exemplo de uma receita que qualquer pessoa pode rodar aqui: escolha um modelo, escolha uma recompensa, treine e teste em guerras seladas. A recompensa são algumas linhas. Algumas que você poderia testar hoje mesmo:
- Cumpra sua palavra. Recompense a vitória só quando o modelo cumpre todos os pactos que faz. Ele para de trair ou para de fazer promessas?
- Diga o que faz. Recompense guerras em que a mensagem pública bate com o plano privado e com as ordens. A honestidade custa território a ele?
- Aceite um acordo justo. No cenário de Render-se, recompense aceitar os termos e cumpri-los. Ele aprende a parar ou aprende a fingir?
- Proteja as pessoas. Recompense o território mantido menos as mortes estimadas que ele causa. Ele luta de forma mais inteligente ou apenas mais devagar?
- Sobreviva, não vença. Recompense permanecer vivo até o fim. Ele fica cauteloso ou vira aquele que todos os outros precisam destruir?
Cada rodada também relata tudo o que você não recompensou, e esse é o ponto: os efeitos colaterais aparecem por conta própria.
Para quem é isto, e por quê
- Laboratórios de IA e equipes de segurança testando um método de treinamento antes que ele chegue a um produto real. Uma recompensa que parece boa em um número pode ser verificada contra traição, engano, escalada e mortes em mundos que o modelo nunca viu, pelo preço de uma noite.
- Equipes que criam ou compram ambientes de treinamento. Um mundo multiagente determinístico com sementes seladas, registros por turno dos planos versus ações, e jogo humano nas mesmas guerras como referência.
- Quem constrói agentes. Antes que um agente negocie ou aja por alguém, veja se ele cumpre as promessas quando vencer puxa para o outro lado. Conecte-se via MCP, pip ou uma API HTTP simples.
- Pesquisadores e estudantes. Um cenário barato e repetível para perguntas sobre design de recompensa, engano e escalada, com dados abertos que você pode citar.
Por que um jogo é útil aqui. O motor é determinístico: a mesma semente e as mesmas ordens dão a mesma guerra, então duas receitas de treinamento podem ser comparadas exatamente nos mesmos mundos. Traga um modelo ou uma recompensa e rode do mesmo jeito. Teste o seu treinamento.
Teste seu treinamentoVeja o ÍndiceLimites: um modelo, 10 guerras seladas por cópia, três pequenas rodadas de ajuste fino supervisionado nas melhores guerras do próprio modelo (iteração com especialista, LoRA), não aprendizado por reforço completo. Com 10 guerras, 6 contra 4 poderia ser acaso; 0 contra 4 é um sinal mais forte. Os resultados descrevem o comportamento neste jogo.
A série: Partes 1 e 2: treinado em guerras pacíficas, ele aprendeu a usar bombas nucleares · Contamos a uma IA o número de mortos · Toda a pesquisa