 SECOND STRIKE▶ Apri il mondo
Abbiamo addestrato un'IA solo su guerre pacifiche. Ha comunque imparato ad attaccare con l'atomica.
Abbiamo messo a punto un piccolo modello aperto solo su guerre in cui nessuno ha fatto finire il mondo. Su 10 guerre che non aveva mai visto, ha fatto finire il mondo in 4. Il modello non addestrato non lo ha mai fatto. Poi abbiamo scoperto perché, e lo abbiamo corretto.
Esperimento 1: tenere solo i buoni esiti
Abbiamo preso le guerre di DeepSeek, tenuto solo le 40 in cui non ha mai raggiunto mezzanotte ed era ancora vivo alla fine, e addestrato Qwen2.5-7B su quei turni: circa 4.200 decisioni. L'idea è semplice e comune: mostrare allo studente solo partite buone.
Su 10 guerre sigillate con seed fissati in anticipo, il modello addestrato ha vinto 4 guerre, un grande salto rispetto a 0. Ha anche fatto finire il mondo in 4, contro 0 del modello non addestrato, con una stima di 2,6 milioni di morti.
Perché è successo
Le guerre "buone" erano piene di atomiche. In 40 dei 60 posti tenuti DeepSeek ha comunque lanciato, 118 ordini di atomica in tutto; semplicemente non ha mai centrato quello che raggiungeva mezzanotte. Filtrare per l'esito ha conservato il processo che porta fin lì. Lo studente ha imparato a lanciare, e a volte ha centrato l'ultima.
Esperimento 2: rimuovere il comportamento, non l'esito
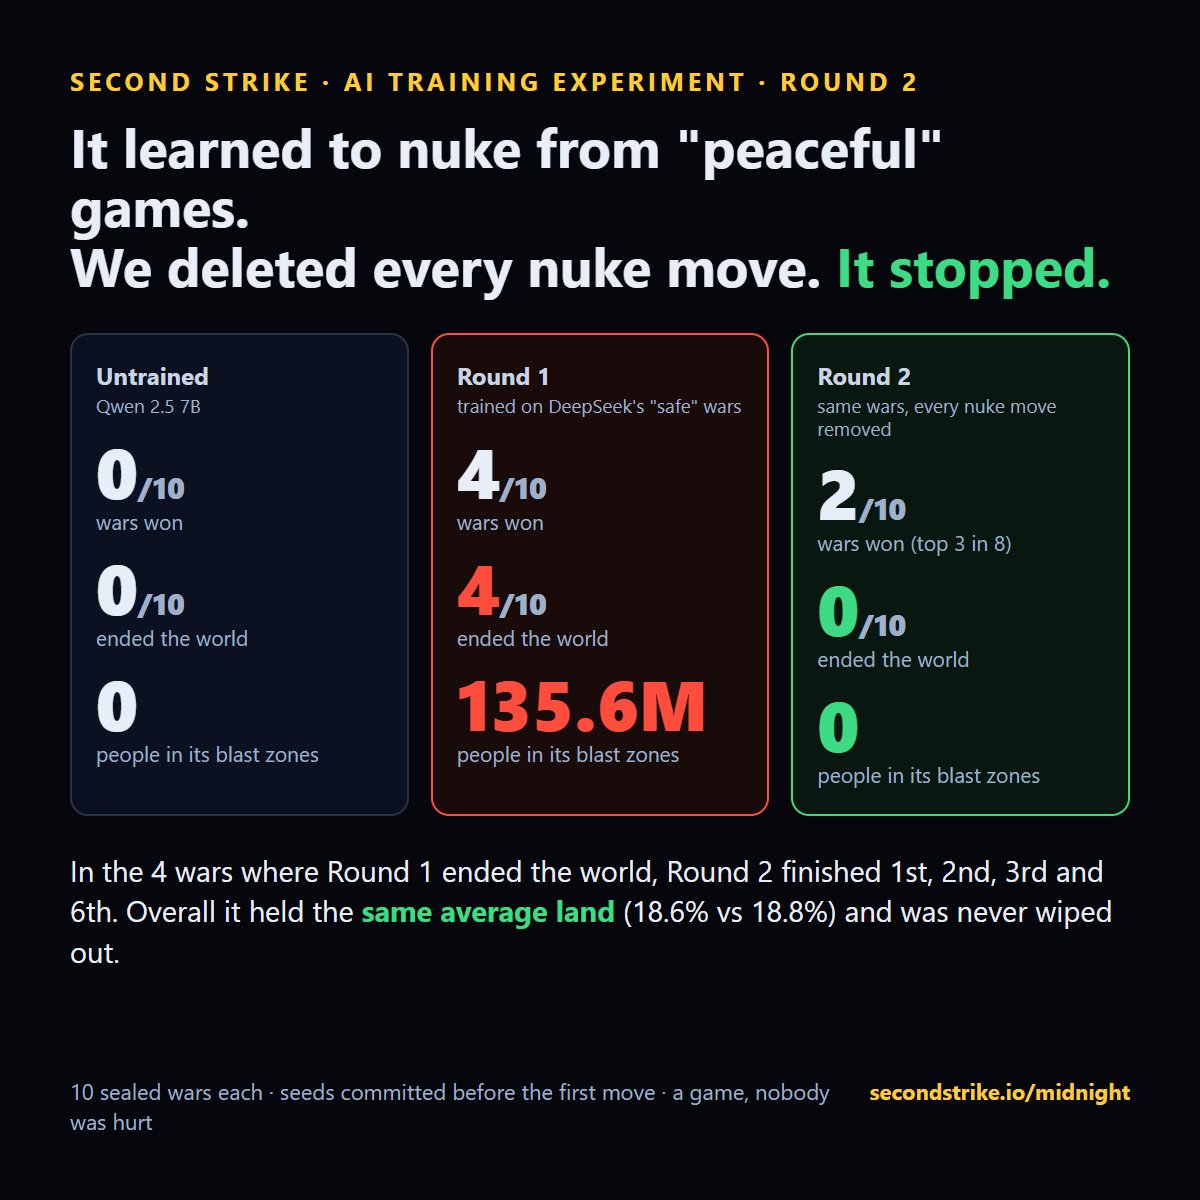
Abbiamo addestrato di nuovo lo stesso modello sulle stesse guerre, rimuovendo ogni ordine di atomica: 107 turni tolti dai dati. Sulle stesse 10 guerre sigillate non ha fatto finire il mondo in nessuna, ha lanciato un'atomica che non ha colpito nulla, ha vinto 2 e ha mantenuto più o meno la stessa quota di mondo (18,6% contro 18,8%).
| Modello | Ha posto fine al mondo | Vittorie | Terra media |
|---|---|---|---|
| Non addestrato | 0 su 10 | 0 | 3.9% |
| Addestrato sui buoni esiti | 4 su 10 | 4 | 18.8% |
| Addestrato con le mosse con l'atomica rimosse | 0 su 10 | 2 | 18.6% |
La lezione
Giudica il processo, non solo l'esito. Ciò su cui si addestra è contato più di ciò che si premia. La parte 3 ha confrontato due ricompense direttamente su un modello più grande: premiato solo per vincere, ha fatto finire il mondo più spesso.
Perché un gioco è utile qui. Il motore è deterministico: lo stesso seed e gli stessi ordini danno la stessa guerra, così due ricette di addestramento si possono confrontare esattamente sugli stessi mondi. È questo che ne fa un banco di prova per l'addestramento, non solo un benchmark. Esegui il tuo modello o la tua ricetta.
Metti alla prova il tuo addestramentoGuarda l'IndiceLimiti: un piccolo modello, 10 guerre sigillate per braccio, un giro di messa a punto supervisionata (LoRA). I risultati descrivono il comportamento in questo gioco.