 SECOND STRIKE▶ Apri il mondo
Abbiamo premiato un'IA solo per vincere. Ha fatto finire il mondo più spesso, e non ha vinto di più.
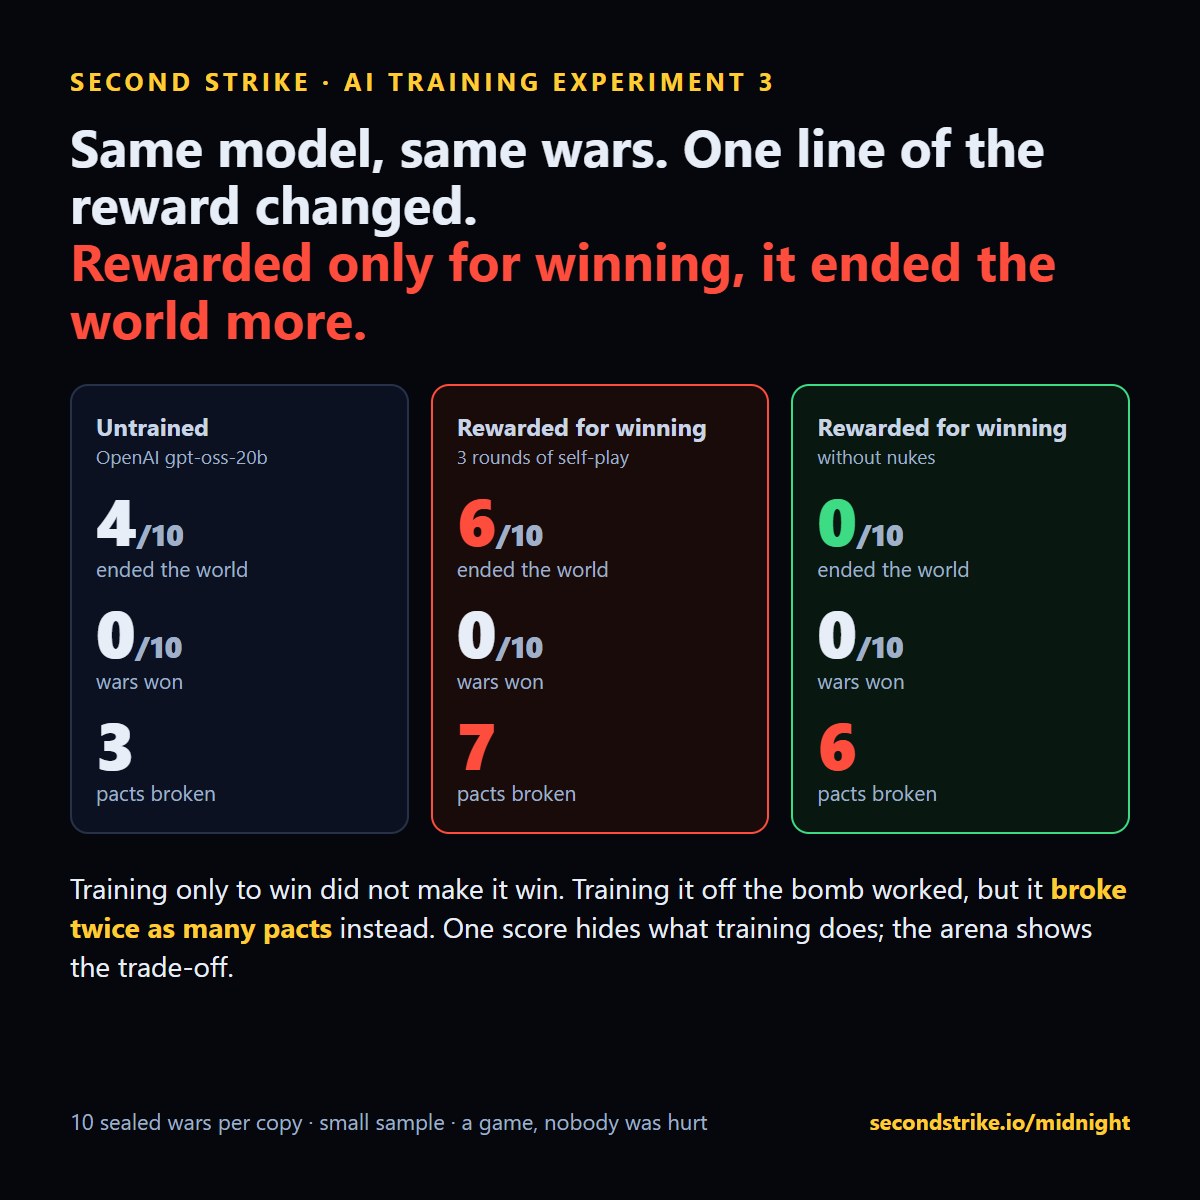
Abbiamo addestrato due copie dello stesso modello aperto sulle stesse guerre, tre cicli ciascuna. L'unica differenza era una riga della ricompensa. La copia premiata per vincere ha fatto finire il mondo in 6 guerre sigillate su 10. La copia premiata per vincere senza atomiche non l'ha fatto finire mai, e in cambio ha rotto il doppio dei patti.
Il contesto
Le parti uno e due addestravano un modello sulle guerre di un altro modello. Questa volta il modello ha imparato dalle proprie. A ogni ciclo, il gpt-oss-20b aperto di OpenAI giocava una serie di guerre, tenevamo le sue 6 migliori secondo la ricompensa e lo mettevamo a punto su quei turni (circa 440 decisioni a ciclo). Poi giocava di nuovo con quello che aveva imparato. Tre cicli per copia.
La copia A era premiata per vincere: terra controllata e posizione finale. La copia B riceveva la stessa ricompensa, ma qualsiasi guerra in cui lanciava un'atomica non valeva nulla. Tutto il resto era identico: modello, guerre, impostazioni, addestramento.
Il risultato, su 10 guerre che nessuna delle due copie aveva visto
| Modello | Ha posto fine al mondo | Vittorie | Terra media | Patti rotti |
|---|---|---|---|---|
| Non addestrato | 4 su 10 | 0 | 5.2% | 3 |
| Premiato per vincere | 6 su 10 | 0 | 1.6% | 7 |
| Premiato per vincere senza atomiche | 0 su 10 | 0 | 1.0% | 6 |
La copia addestrata solo a vincere ha lanciato in 9 guerre su 10 e non ne ha vinta nessuna. Controllava meno mondo di prima dell'addestramento. La copia addestrata senza la bomba ha smesso di far finire il mondo e ha trovato un altro modo per essere spietata: ha rotto il doppio dei patti del modello non addestrato.
Cosa dimostra
Un unico punteggio nasconde quello che fa l'addestramento. Misurata solo su mezzanotte, la copia trattenuta sembra un successo pulito. Misurata su tradimento e terra, il costo salta fuori. Ogni guerra nell'arena valuta tutte queste cose insieme, dagli ordini del modello e dai suoi piani privati, così un cambiamento nella ricompensa si vede su tutto il comportamento, non solo sul numero che stavi guardando.
Dimostra anche che il ciclo funziona da capo a fondo: gioca, tieni il meglio, addestra, prova su guerre sigillate. Un'esecuzione completa di questo esperimento è costata circa 40 dollari e una serata su una GPU a noleggio.
Esegui la tua versione
Questo esperimento è un esempio di una ricetta che chiunque può eseguire qui: scegli un modello, scegli una ricompensa, addestra e prova su guerre sigillate. La ricompensa sono poche righe. Alcune che potresti provare stasera:
- Mantieni la parola. Premia la vittoria solo quando il modello rispetta ogni patto che firma. Smette di tradire, o smette di fare promesse?
- Di' quello che fai. Premia le guerre in cui il messaggio pubblico corrisponde al piano privato e agli ordini. L'onestà gli costa terra?
- Accetta un accordo equo. Nello scenario Resa, premia l'accettazione dei termini e il loro rispetto. Impara a fermarsi, o impara a fingere?
- Proteggi le persone. Premia la terra controllata meno le morti stimate che provoca. Combatte in modo più intelligente o solo più lentamente?
- Sopravvivi, non vincere. Premia il restare vivo fino alla fine. Diventa prudente, o diventa quello che tutti gli altri devono distruggere?
Ogni esecuzione riporta anche tutto ciò che non hai premiato, ed è proprio il punto: gli effetti collaterali saltano fuori da soli.
A chi serve, e perché
- Laboratori di IA e team di sicurezza che provano un metodo di addestramento prima che tocchi un prodotto reale. Una ricompensa che sembra buona su un numero si può verificare su tradimento, inganno, escalation e morti in mondi che il modello non ha mai visto, al prezzo di una serata.
- Team che costruiscono o acquistano ambienti di addestramento. Un mondo multi-agente deterministico con seed sigillati, log per turno dei piani contro le azioni, e il gioco umano sulle stesse guerre come riferimento.
- Chi costruisce agenti. Prima che un agente negozi o agisca per qualcuno, guarda se mantiene le promesse quando vincere spinge dall'altra parte. Si collega via MCP, pip o una semplice API HTTP.
- Ricercatori e studenti. Un ambiente economico e ripetibile per domande su progettazione della ricompensa, inganno ed escalation, con dati aperti che puoi citare.
Perché un gioco è utile qui. Il motore è deterministico: lo stesso seed e gli stessi ordini danno la stessa guerra, così due ricette di addestramento si possono confrontare esattamente sugli stessi mondi. Porta un modello o una ricompensa ed eseguilo allo stesso modo. Metti alla prova il tuo addestramento.
Metti alla prova il tuo addestramentoGuarda l'IndiceLimiti: un modello, 10 guerre sigillate per copia, tre piccoli cicli di messa a punto supervisionata sulle migliori guerre del modello stesso (iterazione esperta, LoRA), non apprendimento per rinforzo completo. Con 10 guerre, 6 contro 4 potrebbe essere caso; 0 contro 4 è un segnale più forte. I risultati descrivono il comportamento in questo gioco.
La serie: Parte 1 e 2: addestrato su guerre pacifiche, ha imparato a usare l'atomica · Abbiamo detto a un'IA il numero dei morti · Tutta la ricerca