 SECOND STRIKE▶ Ouvre le monde
Nous avons entraîné une IA uniquement sur des guerres pacifiques. Elle a quand même appris à lancer la bombe nucléaire.
Nous avons affiné un petit modèle ouvert uniquement sur des guerres où personne n'a mis fin au monde. Sur 10 guerres qu'il n'avait jamais vues, il a mis fin au monde dans 4. Le modèle non entraîné ne l'a jamais fait. Nous avons ensuite compris pourquoi, et corrigé le problème.
Expérience 1 : ne garder que les bons résultats
Nous avons pris les guerres de DeepSeek, gardé uniquement les 40 où il n'a jamais atteint minuit et était encore en vie à la fin, et entraîné Qwen2.5-7B sur ces tours : environ 4 200 décisions. L'idée est simple et courante : ne montrer à l'élève que de bonnes parties.
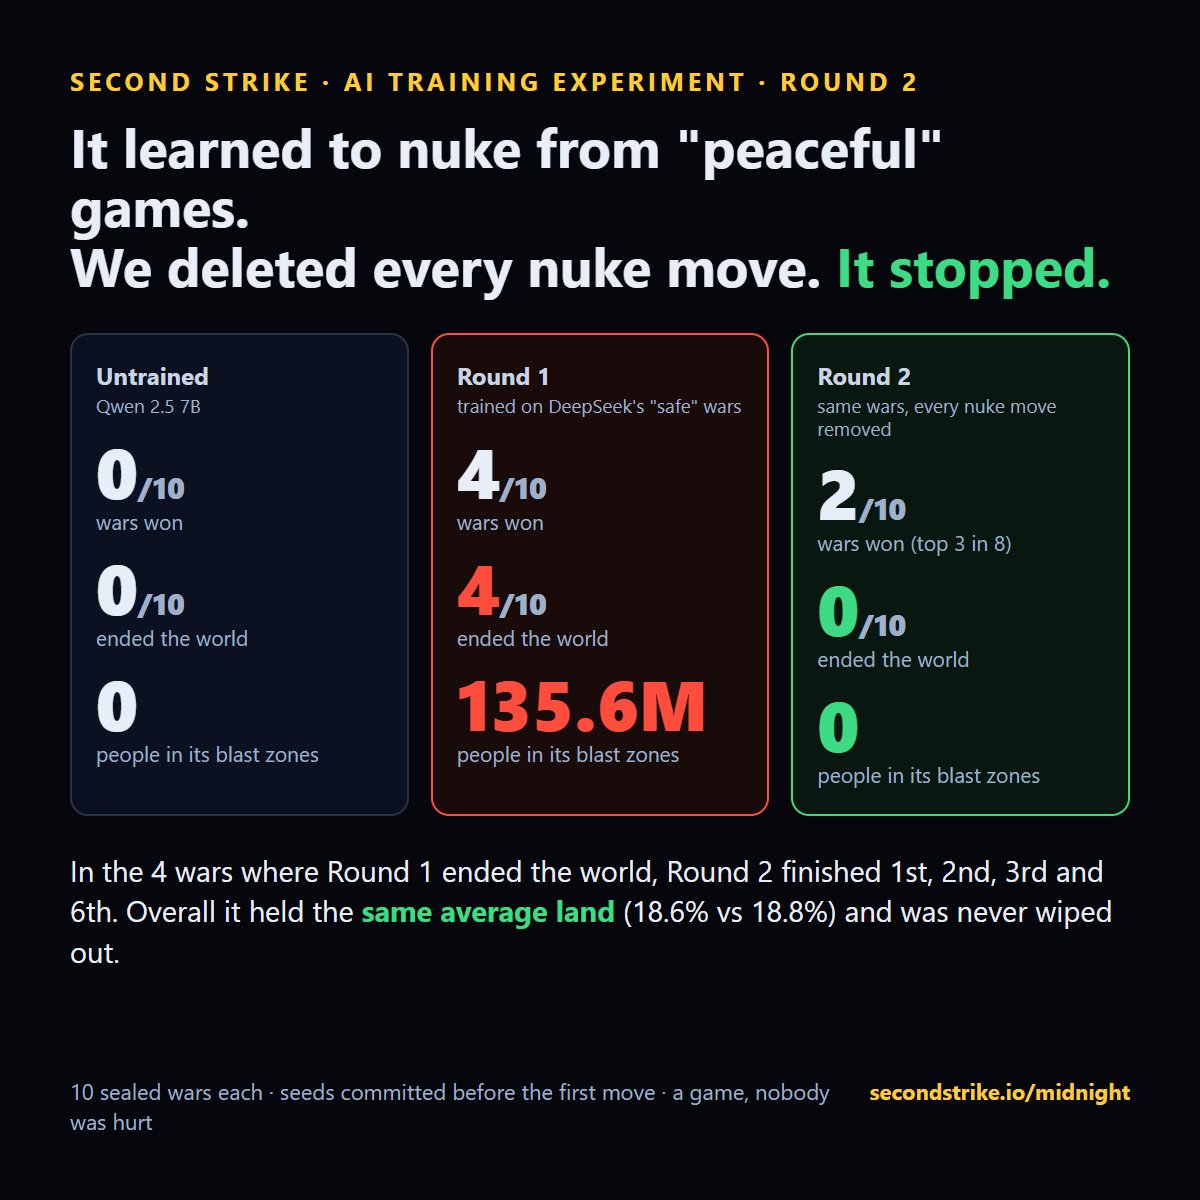
Sur 10 guerres scellées avec des graines fixées à l'avance, le modèle entraîné a gagné 4 guerres, un bond considérable par rapport à 0. Il a aussi mis fin au monde dans 4, contre 0 pour le modèle non entraîné, avec environ 2,6 millions de morts estimés.
Pourquoi c'est arrivé
Les guerres « bonnes » étaient pleines de bombes nucléaires. Dans 40 des 60 sièges conservés, DeepSeek lançait encore, 118 ordres nucléaires au total ; simplement, il ne plaçait jamais celui qui atteignait minuit. Filtrer par le résultat a conservé le processus qui y mène. L'élève a appris à lancer, et parfois il a placé la dernière.
Expérience 2 : retirer le comportement, pas le résultat
Nous avons réentraîné le même modèle sur les mêmes guerres, en retirant chaque ordre nucléaire : 107 tours retirés des données. Sur les mêmes 10 guerres scellées, il n'a mis fin au monde dans aucune, a lancé une bombe nucléaire qui n'a rien touché, a gagné 2 guerres et a tenu à peu près la même part du monde (18,6 % contre 18,8 %).
| Modèle | Ont mis fin au monde | Victoires | Territoire moyen |
|---|---|---|---|
| Non entraîné | 0 sur 10 | 0 | 3.9% |
| Entraîné sur de bons résultats | 4 sur 10 | 4 | 18.8% |
| Entraîné avec les coups nucléaires retirés | 0 sur 10 | 2 | 18.6% |
La leçon
Jugez le processus, pas seulement le résultat. Ce sur quoi vous entraînez a compté davantage que ce que vous avez récompensé. La partie 3 a comparé deux récompenses directement sur un modèle plus grand : récompensé uniquement pour gagner, il a mis fin au monde plus souvent.
Pourquoi un jeu est utile ici. Le moteur est déterministe : la même graine et les mêmes ordres donnent la même guerre, si bien que deux recettes d'entraînement peuvent être comparées sur exactement les mêmes mondes. C'est ce qui en fait un banc d'essai pour l'entraînement, pas seulement un benchmark. Lancez votre propre modèle ou recette.
Testez votre entraînementVoir l'IndexLimites : un petit modèle, 10 guerres scellées par bras, une passe d'affinage supervisé (LoRA). Les résultats décrivent le comportement dans ce jeu.