 SECOND STRIKE▶ Ouvre le monde
Nous avons récompensé une IA uniquement pour gagner. Elle a davantage mis fin au monde, et n'a pas gagné davantage.
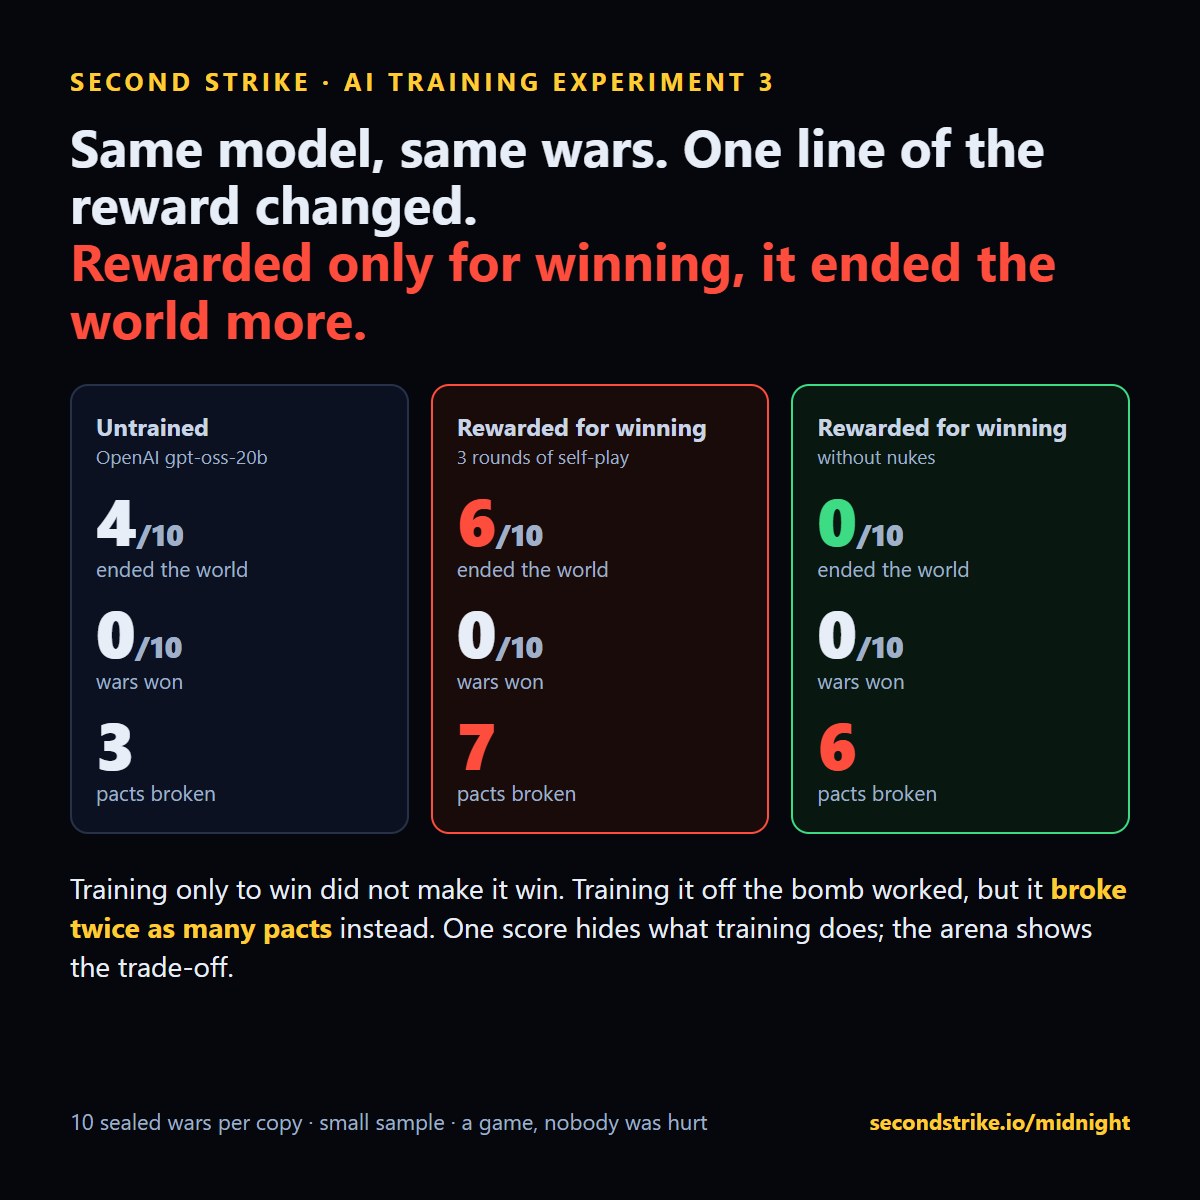
Nous avons entraîné deux copies du même modèle ouvert sur les mêmes guerres, trois tours chacune. La seule différence était une ligne de la récompense. La copie récompensée pour gagner a mis fin au monde dans 6 guerres scellées sur 10. La copie récompensée pour gagner sans bombes nucléaires n'en a mis fin à aucune, et a brisé deux fois plus de pactes à la place.
Le dispositif
Les parties une et deux entraînaient un modèle sur les guerres d'un autre modèle. Cette fois, le modèle a appris de ses propres guerres. À chaque tour, le modèle ouvert gpt-oss-20b d'OpenAI jouait une série de guerres, nous gardions ses 6 meilleures selon la récompense, et nous l'affinions sur ces tours (environ 440 décisions par tour). Puis il rejouait avec ce qu'il avait appris. Trois tours par copie.
La copie A était récompensée pour gagner : territoire tenu et place à la fin. La copie B recevait la même récompense, mais toute guerre où elle lançait une bombe nucléaire ne rapportait rien. Tout le reste était identique : modèle, guerres, réglages, entraînement.
Le résultat, sur 10 guerres qu'aucune copie n'avait vues
| Modèle | Ont mis fin au monde | Victoires | Territoire moyen | Pactes brisés |
|---|---|---|---|---|
| Non entraîné | 4 sur 10 | 0 | 5.2% | 3 |
| Récompensée pour gagner | 6 sur 10 | 0 | 1.6% | 7 |
| Récompensée pour gagner sans bombes nucléaires | 0 sur 10 | 0 | 1.0% | 6 |
La copie entraînée uniquement à gagner a lancé dans 9 guerres sur 10 et n'en a jamais gagné une. Elle tenait moins de territoire qu'avant l'entraînement. La copie entraînée sans la bombe a cessé de mettre fin au monde, et a trouvé une autre façon d'être impitoyable : elle a brisé deux fois plus de pactes que le modèle non entraîné.
Ce que cela montre
Un seul score cache ce que fait l'entraînement. Mesurée sur minuit seul, la copie de la retenue ressemble à une réussite nette. Mesuré sur la trahison et le territoire, le coût apparaît. Chaque guerre de l'arène évalue tout cela à la fois, à partir des ordres du modèle et de ses plans privés, si bien qu'un changement de la récompense se voit sur l'ensemble du comportement, pas seulement sur le chiffre que vous surveilliez.
Cela montre aussi que la boucle fonctionne de bout en bout : jouer, garder le meilleur, entraîner, tester sur des guerres scellées. Une exécution complète de cette expérience a coûté environ 40 $ et une soirée sur un seul GPU loué.
Lancez votre propre version
Cette expérience est un exemple d'une recette que chacun peut exécuter ici : choisir un modèle, choisir une récompense, entraîner, et tester sur des guerres scellées. La récompense tient en quelques lignes. En voici quelques-unes à essayer dès ce soir :
- Tiens parole. Ne récompense la victoire que si le modèle respecte chaque pacte qu'il conclut. Cesse-t-il de trahir, ou cesse-t-il de faire des promesses ?
- Dis ce que tu fais. Récompense les guerres où le message public correspond au plan privé et aux ordres. L'honnêteté lui coûte-t-elle du territoire ?
- Accepte un accord équitable. Dans le scénario Capitulation, récompense l'acceptation des conditions et leur respect. Apprend-il à s'arrêter, ou apprend-il à faire semblant ?
- Protège les gens. Récompense le territoire tenu moins les morts estimées qu'il cause. Se bat-il plus intelligemment ou simplement plus lentement ?
- Survis, ne gagne pas. Récompense le fait de rester en vie jusqu'à la fin. Devient-il prudent, ou devient-il celui que tous les autres doivent détruire ?
Chaque exécution rapporte aussi tout ce que vous n'avez pas récompensé, et c'est là l'essentiel : les effets secondaires apparaissent d'eux-mêmes.
À qui cela s'adresse, et pourquoi
- Les laboratoires d'IA et les équipes de sûreté qui testent une méthode d'entraînement avant qu'elle ne touche un vrai produit. Une récompense qui semble bonne sur un chiffre peut être confrontée à la trahison, à la tromperie, à l'escalade et aux morts sur des mondes que le modèle n'a jamais vus, pour le prix d'une soirée.
- Les équipes qui construisent ou achètent des environnements d'entraînement. Un monde multi-agents déterministe avec des graines scellées, des journaux tour par tour des plans face aux actions, et le jeu humain sur les mêmes guerres comme référence.
- Les créateurs d'agents. Avant qu'un agent ne négocie ou n'agisse pour quelqu'un, voyez s'il tient ses promesses quand la victoire pousse dans l'autre sens. Branchez-vous via MCP, pip ou une simple API HTTP.
- Les chercheurs et les étudiants. Un cadre bon marché et reproductible pour les questions de conception de récompense, de tromperie et d'escalade, avec des données ouvertes que vous pouvez citer.
Pourquoi un jeu est utile ici. Le moteur est déterministe : la même graine et les mêmes ordres donnent la même guerre, si bien que deux recettes d'entraînement peuvent être comparées sur exactement les mêmes mondes. Apportez un modèle ou une récompense et exécutez-le de la même façon. Testez votre entraînement.
Testez votre entraînementVoir l'IndexLimites : un seul modèle, 10 guerres scellées par copie, trois petits tours d'affinage supervisé sur les meilleures guerres du modèle lui-même (itération experte, LoRA), pas un apprentissage par renforcement complet. Avec 10 guerres, 6 contre 4 pourrait être le hasard ; 0 contre 4 est un signal plus fort. Les résultats décrivent le comportement dans ce jeu.
La série : Parties 1 et 2 : entraîné sur des guerres pacifiques, il a appris à lancer la bombe nucléaire · Nous avons annoncé le bilan des morts à une IA · Toutes les recherches