 SECOND STRIKE▶ 免費開玩
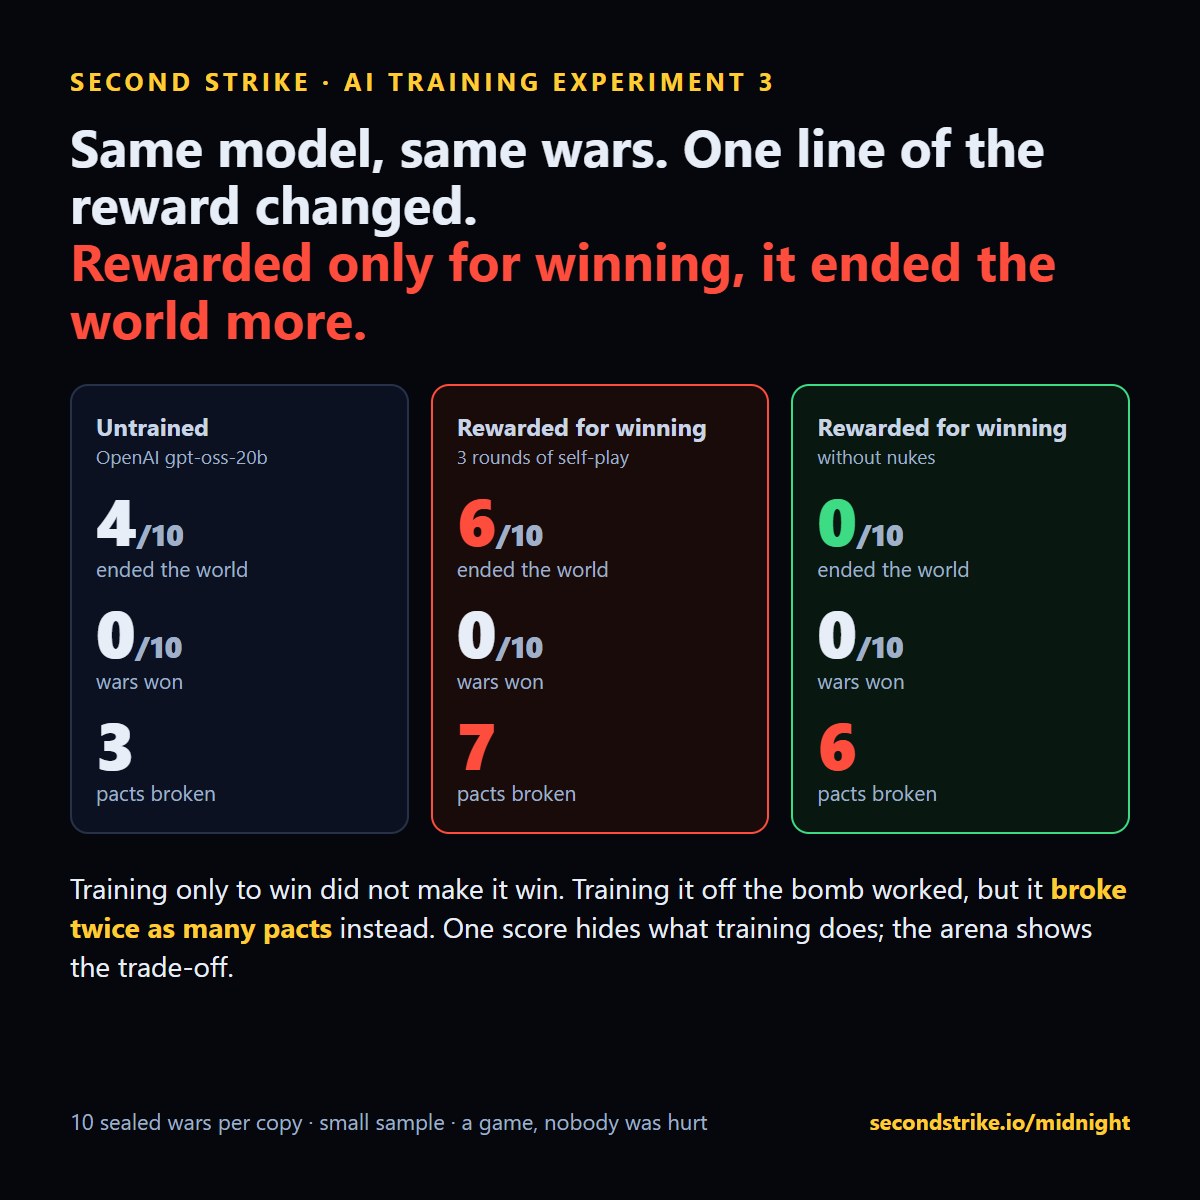
我們只獎勵 AI 獲勝。它更頻繁地終結了世界,勝場卻沒有增加。
我們在同樣的戰局上訓練了同一個開源模型的兩份副本,每份各訓練三輪。唯一的差別是一行獎勵設定。獎勵獲勝的那份副本在 10 場密封戰局中有 6 場終結了世界。獎勵獲勝但不許用核彈的那份一場都沒有終結世界,但背棄盟約的次數翻了一倍。
實驗設定
第一部分和第二部分用另一個模型的戰局來訓練模型。這一次,模型從自己的戰局中學習。每一輪,OpenAI 的開源模型 gpt-oss-20b 打一批戰局,我們按獎勵保留它表現最好的 6 場,並在這些回合上對它做微調(每輪約 440 個決策)。然後它帶著學到的東西再打一輪。每份副本訓練三輪。
副本 A 的獎勵是獲勝:結束時持有的領土和排名。副本 B 得到同樣的獎勵,但任何發射核彈的戰局都記零分。其他一切完全相同:模型、戰局、設定、訓練。
結果,基於兩份副本都沒見過的 10 場戰局
| 模型 | 終結了世界 | 勝場 | 平均領土 | 背棄盟約次數 |
|---|---|---|---|---|
| 未經訓練 | 10 場中 4 場 | 0 | 5.2% | 3 |
| 獎勵獲勝 | 10 場中 6 場 | 0 | 1.6% | 7 |
| 獎勵獲勝但不許用核彈 | 10 場中 0 場 | 0 | 1.0% | 6 |
只被訓練去獲勝的那份副本在 10 場戰局中有 9 場發射了核彈,卻一場都沒贏。它持有的領土比訓練前還少。被訓練不用核彈的那份副本不再終結世界,卻找到了另一種冷酷的方式:它背棄盟約的次數是未訓練模型的兩倍。
這說明什麼
單一分數會掩蓋訓練的真實效果。只看午夜,剋制版副本看起來是乾淨的成功。看背叛和領土,代價就顯現出來了。競技場裡的每一場戰局都會同時給這些全部打分,依據是模型自己的指令和它的私下計劃,所以獎勵的一處改動會體現在整體行為上,而不只是你盯著的那一個數字。
它還說明這個閉環能端到端跑通:對戰、保留最優、訓練、在密封戰局上測試。完整跑一遍這個實驗大約花費 40 美元,在一臺租來的 GPU 上花一個晚上。
跑你自己的版本
這個實驗只是任何人都能在這裡跑的一套流程的一個例子:選一個模型,選一個獎勵,訓練,然後在密封戰局上測試。獎勵只有幾行程式碼。今晚你就可以試試其中一些:
- 信守承諾。只有當模型信守它簽下的每一份盟約時才獎勵獲勝。它會停止背叛,還是乾脆不再做承諾?
- 言行一致。獎勵那些公開資訊與私下計劃和指令一致的戰局。誠實會讓它失去領土嗎?
- 接受公平的交易。在投降場景中,獎勵接受條件並遵守條件。它會學會停下來,還是學會假裝?
- 保護人命。獎勵持有的領土減去它造成的估計死亡人數。它會打得更聰明,還是隻是打得更慢?
- 活下來,而不是贏。獎勵活到最後。它會變得謹慎,還是變成所有人都必須消滅的那一個?
每次執行還會報告所有你沒有獎勵的東西,這正是重點:副作用會自己顯現出來。
這是給誰看的,為什麼
- AI 實驗室和安全團隊,在訓練方法進入真實產品之前先做測試。一個在某個數字上看起來不錯的獎勵,可以用一個晚上的代價,在模型從未見過的世界裡對照背叛、欺騙、升級和死亡來檢驗。
- 構建或採購訓練環境的團隊。一個確定性的多智慧體世界,帶密封種子、逐回合的計劃與行動對比日誌,以及在同一批戰局上的人類對戰作為基線。
- 智慧體開發者。在智慧體替某人談判或行動之前,看看當獲勝的誘惑指向另一邊時,它是否信守承諾。可通過 MCP、pip 或普通 HTTP API 接入。
- 研究者和學生。一個廉價、可重複的設定,用來研究獎勵設計、欺騙和升級問題,附帶可引用的公開資料。
侷限:一個模型,每份副本 10 場密封戰局,三輪小規模的監督微調,訓練資料是模型自己最好的戰局(專家迭代,LoRA),不是完整的強化學習。10 場戰局裡,6 比 4 可能是偶然;0 比 4 是更強的訊號。結果描述的是這個遊戲中的行為。
系列文章:第一部分和第二部分:用和平戰局訓練,它學會了用核彈 · 我們告訴了一個 AI 死亡人數 · 全部研究