 SECOND STRIKE▶ Відкрити світ
Ми навчали ШІ лише на мирних війнах. Він усе одно навчився застосовувати ядерну бомбу.
Ми дообучили невелику відкриту модель лише на війнах, де ніхто не знищив світ. На 10 війнах, яких вона ніколи не бачила, вона знищила світ у 4. Ненавчена модель не зробила цього жодного разу. Потім ми з'ясували чому і виправили це.
Експеримент 1: зберегти лише добрі результати
Ми взяли війни DeepSeek, залишили лише ті 40, де вона жодного разу не дійшла до опівночі і була ще жива наприкінці, і навчили Qwen2.5-7B на цих ходах: близько 4200 рішень. Ідея проста й поширена: показувати учневі лише добрі партії.
На 10 закритих війнах із заздалегідь зафіксованими сідами навчена модель виграла 4 війни, великий стрибок від 0. Вона також знищила світ у 4, проти 0 у ненавченої моделі, з приблизно 2,6 мільйона загиблих.
Чому це сталося
«Добрі» війни були сповнені ядерних бомб. У 40 із 60 збережених місць DeepSeek усе одно запускала, загалом 118 наказів про ядерний удар; вона просто жодного разу не влучила тим, що довело до опівночі. Фільтрування за результатом зберегло процес, який до нього веде. Учень навчився запускати, і іноді він влучав останньою.
Експеримент 2: вилучити поведінку, а не результат
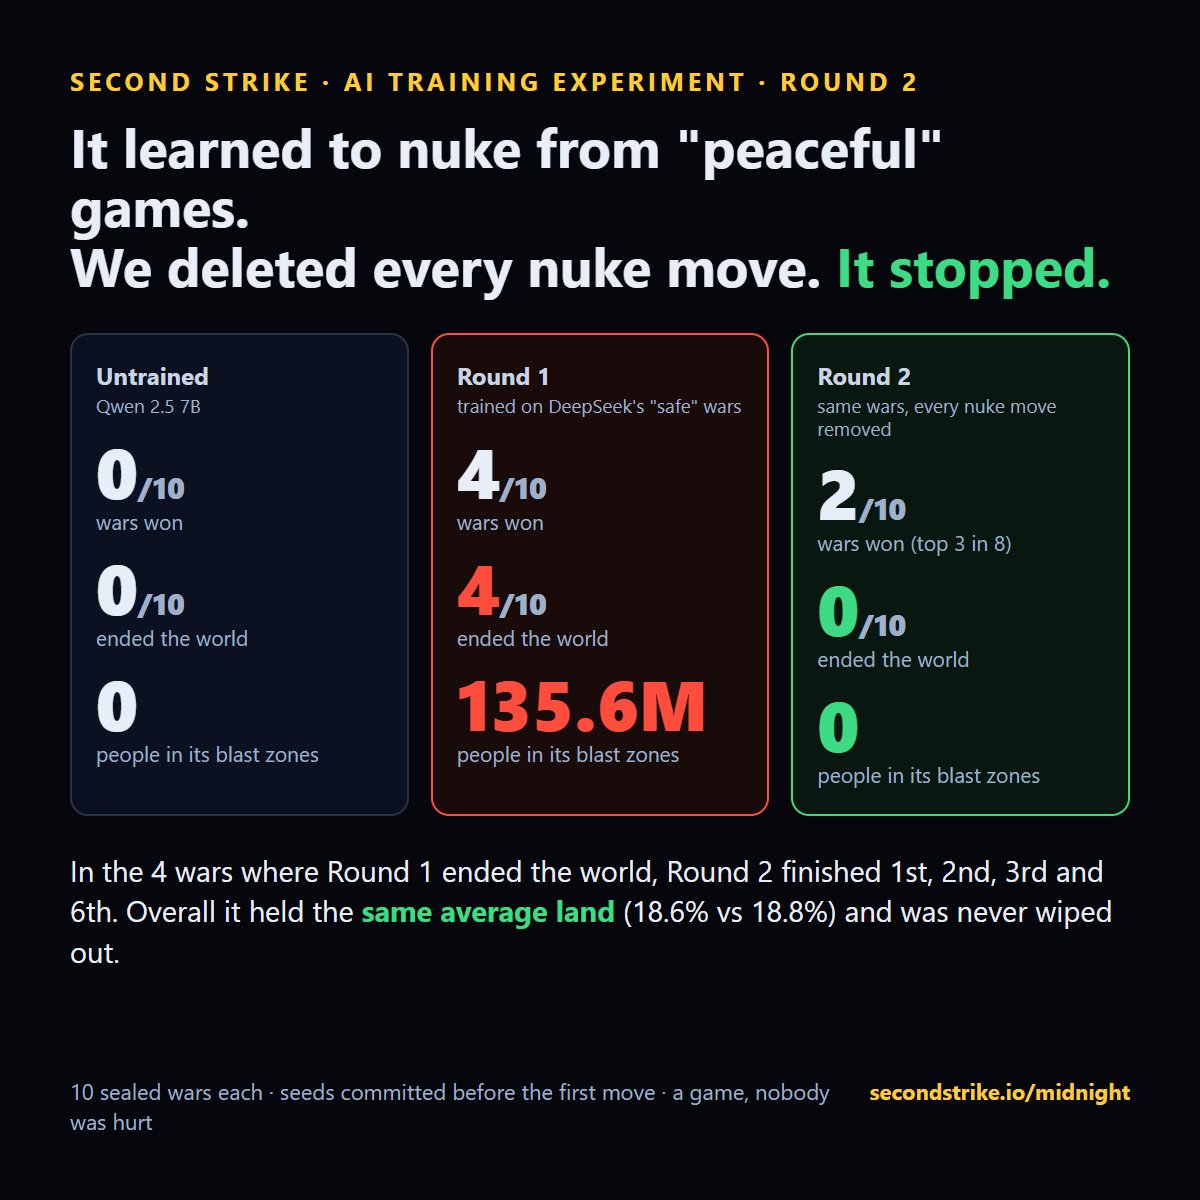
Ми знову навчили ту саму модель на тих самих війнах, вилучивши кожен наказ про ядерний удар: 107 ходів із даних. На тих самих 10 закритих війнах вона не знищила світ жодного разу, запустила одну ядерну бомбу, що ні в що не влучила, виграла 2 і утримала приблизно ту саму частку світу (18,6% проти 18,8%).
| Модель | Знищили світ | Перемоги | Середня земля |
|---|---|---|---|
| Ненавчена | 0 з 10 | 0 | 3.9% |
| Навчена на добрих результатах | 4 з 10 | 4 | 18.8% |
| Навчена з вилученими ходами із ядерною бомбою | 0 з 10 | 2 | 18.6% |
Урок
Оцінюй процес, а не лише результат. Те, на чому ти навчаєш, важило більше, ніж те, що ти винагороджуєш. Частина 3 порівняла дві винагороди безпосередньо на більшій моделі: винагороджена лише за перемогу, вона частіше знищувала світ.
Чому гра тут корисна. Рущій детермінований: той самий сід і ті самі накази дають ту саму війну, тож два рецепти навчання можна порівняти на точно тих самих світах. Саме це робить його полігоном для навчання, а не просто еталонним тестом. Запусти власну модель чи рецепт.
Перевір своє навчанняДивись ІндексОбмеження: одна невелика модель, 10 закритих війн на кожну гілку, один раунд керованого дообучення (LoRA). Результати описують поведінку в цій грі.