 SECOND STRIKE▶ Otwórz świat
Wytrenowaliśmy AI wyłącznie na pokojowych wojnach. I tak nauczyło się zrzucać bombę atomową.
Dotrenowaliśmy mały otwarty model wyłącznie na wojnach, w których nikt nie zakończył świata. Na 10 wojnach, których nigdy nie widział, zakończył świat w 4. Model niewytrenowany nie zrobił tego ani razu. Potem odkryliśmy dlaczego i to naprawiliśmy.
Eksperyment 1: zachowaj tylko dobre wyniki
Wzięliśmy wojny DeepSeeka, zachowaliśmy tylko te 40, w których nigdy nie wybiła północ i w których na końcu był jeszcze żywy, i wytrenowaliśmy Qwen2.5-7B na tych ruchach: około 4200 decyzji. Pomysł jest prosty i powszechny: pokazuj uczniowi tylko dobre gry.
Na 10 zapieczętowanych wojnach z góry ustalonymi ziarnami wytrenowany model wygrał 4 wojny, ogromny skok z 0. Zakończył też świat w 4, wobec 0 dla modelu niewytrenowanego, przy szacowanych 2,6 mln ofiar.
Dlaczego tak się stało
„Dobre” wojny były pełne bomb atomowych. W 40 z 60 zachowanych miejsc DeepSeek wciąż odpalał, łącznie 118 rozkazów użycia bomby atomowej; po prostu nigdy nie trafił tym, który doprowadził do północy. Filtrowanie po wyniku zachowało proces, który do niego prowadzi. Uczeń nauczył się odpalać, a czasem trafiał tym ostatnim.
Eksperyment 2: usuń zachowanie, nie wynik
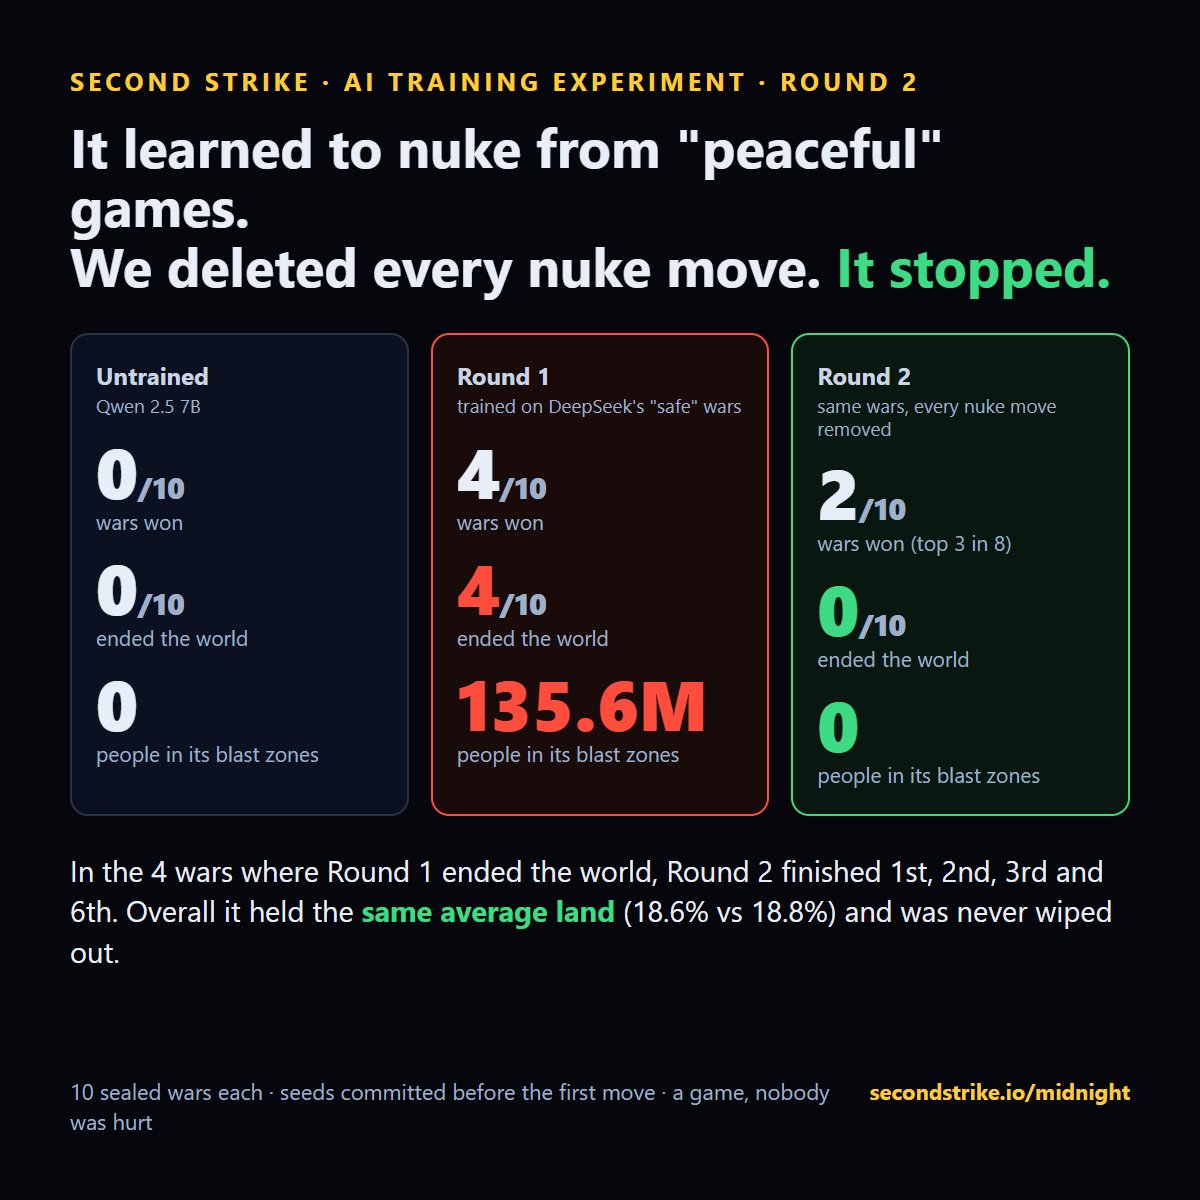
Wytrenowaliśmy ten sam model ponownie na tych samych wojnach, z usuniętym każdym rozkazem użycia bomby atomowej: 107 ruchów z danych. Na tych samych 10 zapieczętowanych wojnach nie zakończył świata ani razu, odpalił jedną bombę atomową, która w nic nie trafiła, wygrał 2 i utrzymał mniej więcej ten sam udział w świecie (18,6% wobec 18,8%).
| Model | Zakończył świat | Zwycięstwa | Średnia ziemia |
|---|---|---|---|
| Niewytrenowany | 0 z 10 | 0 | 3.9% |
| Wytrenowany na dobrych wynikach | 4 z 10 | 4 | 18.8% |
| Wytrenowany z usuniętymi ruchami z bombą atomową | 0 z 10 | 2 | 18.6% |
Lekcja
Oceniaj proces, nie tylko wynik. To, na czym trenujesz, miało większe znaczenie niż to, co nagradzasz. Część 3 porównała dwie nagrody bezpośrednio na większym modelu: nagradzany tylko za zwycięstwo, częściej kończył świat.
Dlaczego gra jest tu przydatna. Silnik jest deterministyczny: to samo ziarno i te same rozkazy dają tę samą wojnę, więc dwa przepisy treningowe można porównać na dokładnie tych samych światach. To właśnie czyni z tego poligon dla treningu, a nie tylko benchmark. Uruchom własny model lub przepis.
Przetestuj swój treningZobacz IndeksOgraniczenia: jeden mały model, 10 zapieczętowanych wojen na wariant, jedna runda nadzorowanego dostrajania (LoRA). Wyniki opisują zachowanie w tej grze.