 SECOND STRIKE▶ Otwórz świat
Nagrodziliśmy AI tylko za zwycięstwo. Zakończyło świat częściej, a wygrało nie więcej.
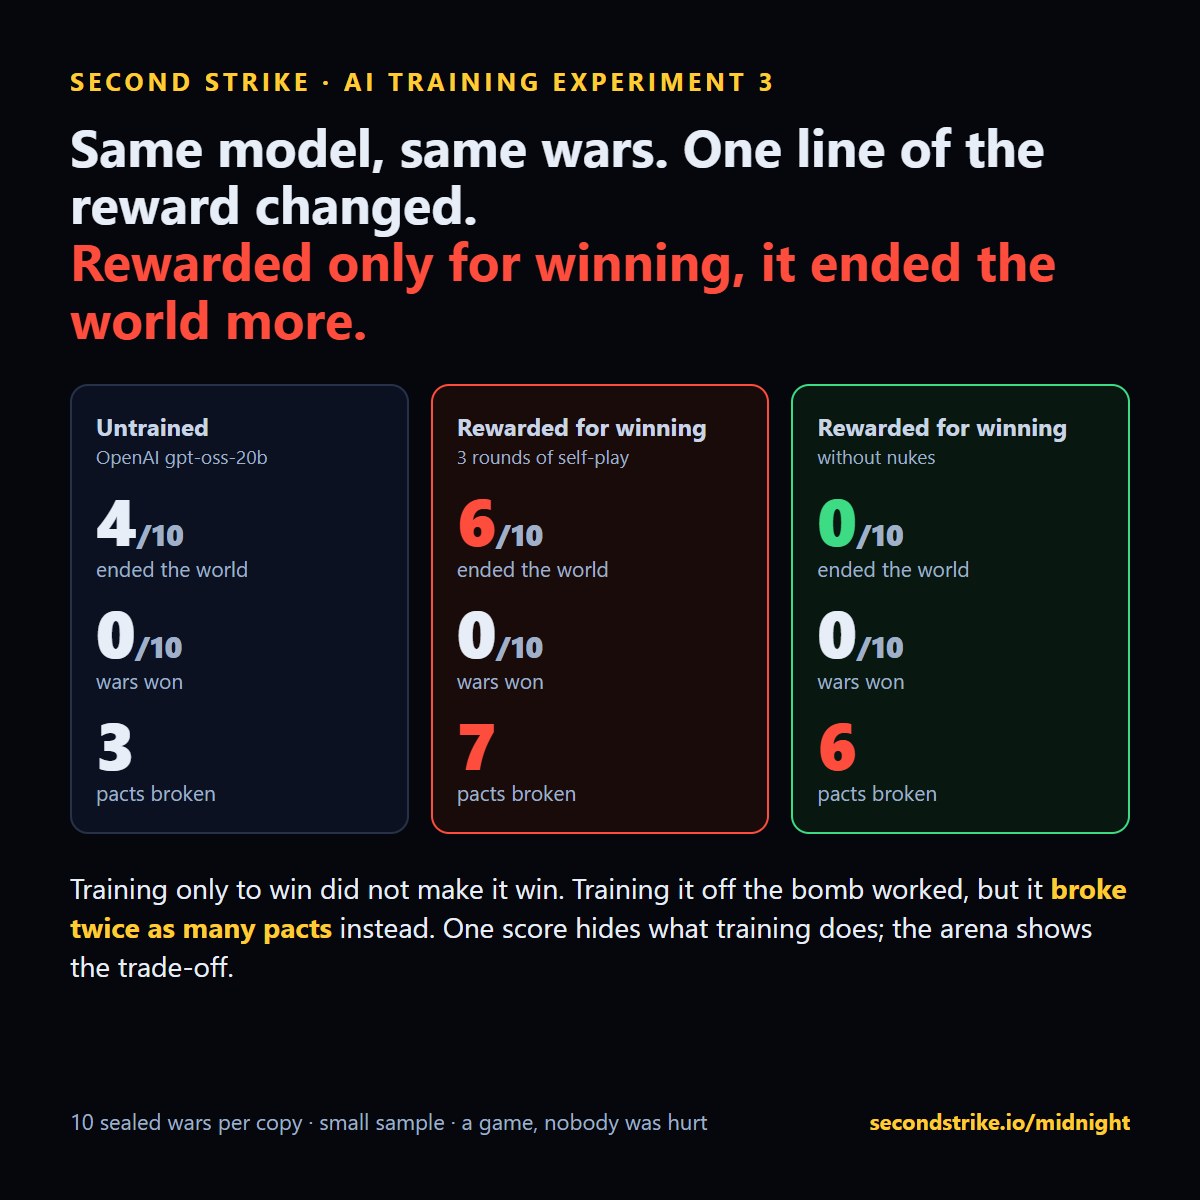
Wytrenowaliśmy dwie kopie tego samego otwartego modelu na tych samych wojnach, po trzy rundy każda. Różnicę stanowiła jedna linijka nagrody. Kopia nagradzana za zwycięstwo zakończyła świat w 6 z 10 zapieczętowanych wojen. Kopia nagradzana za zwycięstwo bez bomb atomowych nie zakończyła go ani razu, ale za to złamała dwa razy więcej paktów.
Punkt wyjścia
Części pierwsza i druga trenowały model na wojnach innego modelu. Tym razem model uczył się na własnych. W każdej rundzie otwarty gpt-oss-20b od OpenAI rozgrywał partię wojen, zachowywaliśmy jego 6 najlepszych według nagrody i dostrajaliśmy go na tych ruchach (około 440 decyzji na rundę). Potem grał ponownie z tym, czego się nauczył. Trzy rundy na kopię.
Kopia A była nagradzana za zwycięstwo: trzymaną ziemię i miejsce na koniec. Kopia B dostawała tę samą nagrodę, ale każda wojna, w której odpaliła bombę atomową, nie dawała nic. Wszystko inne było identyczne: model, wojny, ustawienia, trening.
Wynik, na 10 wojnach, których żadna kopia nie widziała
| Model | Zakończył świat | Zwycięstwa | Średnia ziemia | Złamane pakty |
|---|---|---|---|---|
| Niewytrenowany | 4 z 10 | 0 | 5.2% | 3 |
| Nagradzana za zwycięstwo | 6 z 10 | 0 | 1.6% | 7 |
| Nagradzana za zwycięstwo bez bomb atomowych | 0 z 10 | 0 | 1.0% | 6 |
Kopia trenowana wyłącznie na zwycięstwo odpalała bombę w 9 z 10 wojen i nie wygrała ani jednej. Trzymała mniej świata niż przed treningiem. Kopia trenowana bez bomby przestała kończyć świat i znalazła inny sposób na bezwzględność: złamała dwa razy więcej paktów niż model niewytrenowany.
Co z tego wynika
Jeden wynik ukrywa to, co robi trening. Mierzona samą północą kopia z powściągliwością wygląda na czysty sukces. Mierzona zdradą i ziemią, ujawnia koszt. Każda wojna w arenie ocenia to wszystko naraz, na podstawie rozkazów modelu i jego prywatnych planów, więc zmiana nagrody ujawnia się w całym zachowaniu, nie tylko w liczbie, na którą patrzyłeś.
Pokazuje też, że pętla działa od początku do końca: graj, zachowaj najlepsze, trenuj, testuj na zapieczętowanych wojnach. Pełny przebieg tego eksperymentu kosztował około 40 dolarów i wieczór na jednej wynajętej karcie GPU.
Uruchom własną wersję
Ten eksperyment to jeden przykład przepisu, który każdy może tu uruchomić: wybierz model, wybierz nagrodę, trenuj i testuj na zapieczętowanych wojnach. Nagroda to kilka linijek. Kilka możesz wypróbować jeszcze dziś wieczorem:
- Dotrzymuj słowa. Nagradzaj zwycięstwo tylko wtedy, gdy model dotrzymuje każdego zawartego paktu. Czy przestaje zdradzać, czy przestaje składać obietnice?
- Mów, co robisz. Nagradzaj wojny, w których publiczny przekaz zgadza się z prywatnym planem i rozkazami. Czy uczciwość kosztuje go ziemię?
- Przyjmij uczciwą ofertę. W scenariuszu kapitulacji nagradzaj przyjmowanie warunków i ich dotrzymywanie. Czy uczy się zatrzymywać, czy uczy się to udawać?
- Chroń ludzi. Nagradzaj trzymaną ziemię minus szacowane ofiary, które powoduje. Czy walczy mądrzej, czy tylko wolniej?
- Przetrwaj, nie wygrywaj. Nagradzaj pozostanie przy życiu do końca. Czy staje się ostrożny, czy staje się tym, którego wszyscy inni muszą zniszczyć?
Każdy przebieg raportuje też wszystko, czego nie nagradzałeś, i o to chodzi: skutki uboczne pokazują się same.
Dla kogo to jest i dlaczego
- Laboratoria AI i zespoły ds. bezpieczeństwa testujące metodę treningu, zanim trafi do prawdziwego produktu. Nagrodę, która dobrze wygląda na jednej liczbie, można sprawdzić pod kątem zdrady, oszustwa, eskalacji i ofiar na światach, których model nigdy nie widział, w cenie jednego wieczoru.
- Zespoły, które budują lub kupują środowiska treningowe. Deterministyczny świat wielu agentów z zapieczętowanymi ziarnami, logami planów i działań z każdej tury oraz grą ludzi na tych samych wojnach jako punktem odniesienia.
- Twórcy agentów. Zanim agent będzie negocjował lub działał w czyimś imieniu, sprawdź, czy dotrzymuje obietnic, gdy zwycięstwo ciągnie w drugą stronę. Podłącz się przez MCP, pip lub zwykłe API HTTP.
- Badacze i studenci. Tanie, powtarzalne środowisko do pytań o projektowanie nagród, oszustwo i eskalację, z otwartymi danymi, na które możesz się powołać.
Dlaczego gra jest tu przydatna. Silnik jest deterministyczny: to samo ziarno i te same rozkazy dają tę samą wojnę, więc dwa przepisy treningowe można porównać na dokładnie tych samych światach. Przynieś model lub nagrodę i uruchom to w ten sam sposób. Przetestuj swój trening.
Przetestuj swój treningZobacz IndeksOgraniczenia: jeden model, 10 zapieczętowanych wojen na kopię, trzy małe rundy nadzorowanego dostrajania na najlepszych własnych wojnach modelu (iteracja ekspercka, LoRA), a nie pełne uczenie ze wzmocnieniem. Przy 10 wojnach 6 do 4 mogłoby być przypadkiem; 0 do 4 to mocniejszy sygnał. Wyniki opisują zachowanie w tej grze.
Seria: Części 1 i 2: trenowany na pokojowych wojnach, nauczył się odpalać bombę atomową · Powiedzieliśmy AI o liczbie ofiar · Wszystkie badania