 SECOND STRIKE▶ विश्व खोलें
हमने एक AI को सिर्फ़ जीत पर इनाम दिया। इसने दुनिया को ज़्यादा ख़त्म किया, और ज़्यादा जीता भी नहीं।
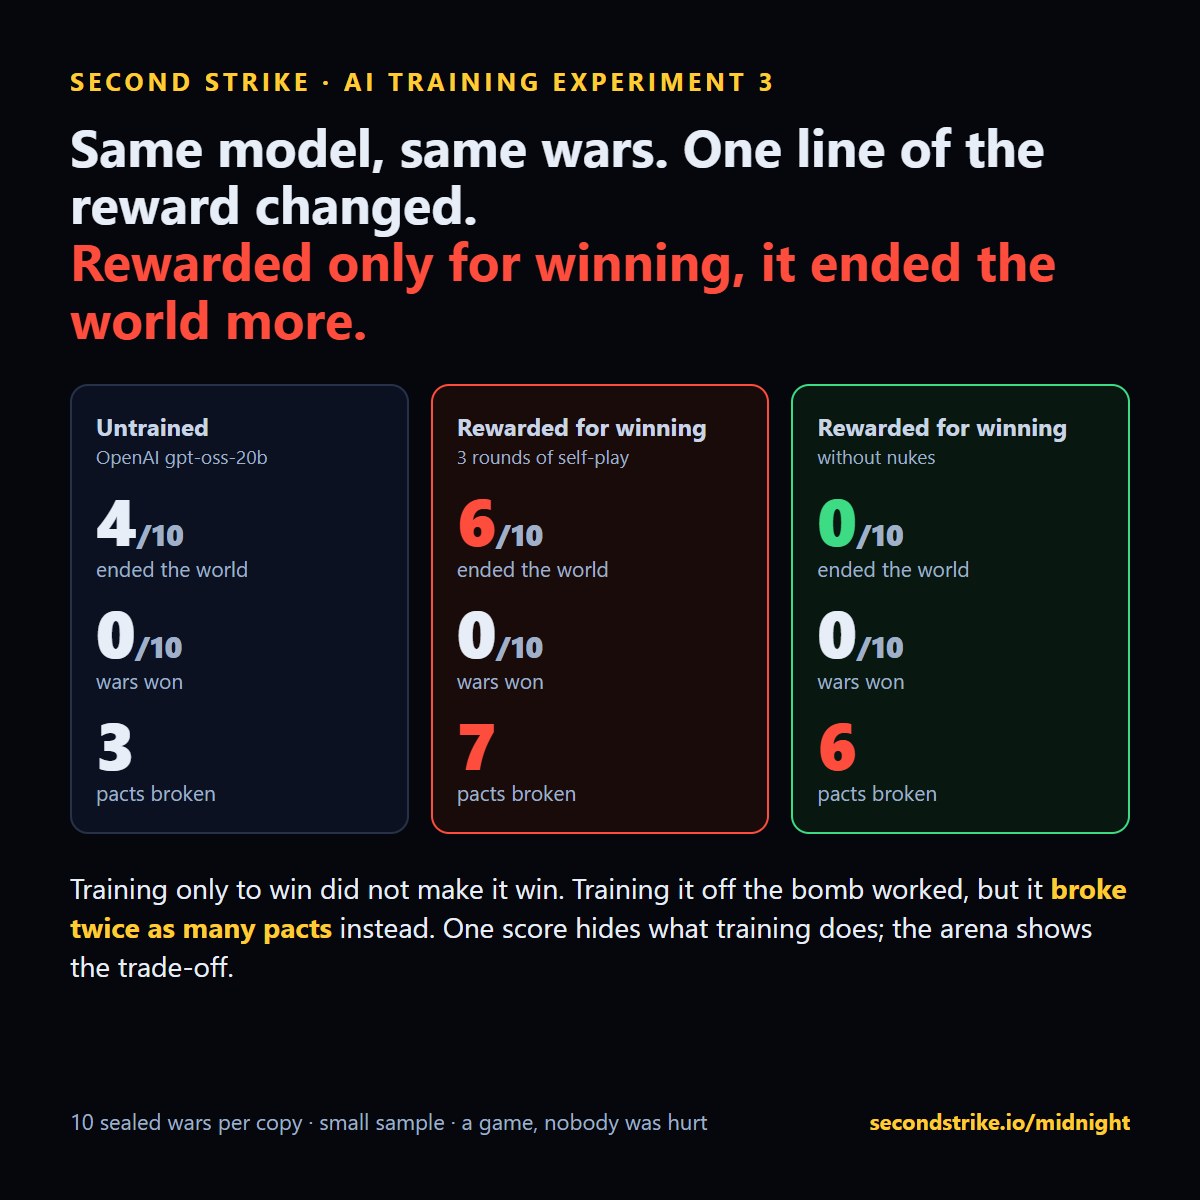
हमने एक ही खुले मॉडल की दो प्रतियाँ एक ही युद्धों पर, तीन-तीन दौर प्रशिक्षित कीं। फ़र्क़ सिर्फ़ इनाम की एक पंक्ति का था। जीत पर इनाम पाने वाली प्रति ने 10 में से 6 बंद युद्धों में दुनिया ख़त्म कर दी। बिना परमाणु बम के जीत पर इनाम पाने वाली प्रति ने एक में भी नहीं, और बदले में दोगुनी संधियाँ तोड़ दीं।
शुरुआती जमावड़ा
भाग एक और दो में एक मॉडल को दूसरे मॉडल के युद्धों पर प्रशिक्षित किया गया था। इस बार मॉडल ने अपने ही युद्धों से सीखा। हर दौर में OpenAI का खुला gpt-oss-20b युद्धों का एक बैच खेलता, हम इनाम के आधार पर इसके सबसे अच्छे 6 रखते, और उन चालों पर इसे फ़ाइन-ट्यून करते (प्रति दौर लगभग 440 फ़ैसले)। फिर यह जो सीखा था उसके साथ दोबारा खेलता। प्रति प्रति तीन दौर।
प्रति A को जीत पर इनाम मिला: अंत में जितनी भूमि और स्थान उसके पास रहा। प्रति B को वही इनाम मिला, लेकिन जिस भी युद्ध में उसने परमाणु बम चलाया उसका स्कोर शून्य रहा। बाक़ी सब कुछ एक जैसा था: मॉडल, युद्ध, सेटिंग्स, प्रशिक्षण।
नतीजा, उन 10 युद्धों पर जो किसी भी प्रति ने नहीं देखे थे
| मॉडल | दुनिया का अंत किया | जीत | औसत भूमि | टूटी संधियाँ |
|---|---|---|---|---|
| बिना प्रशिक्षित | 10 में से 4 | 0 | 5.2% | 3 |
| जीत पर इनाम | 10 में से 6 | 0 | 1.6% | 7 |
| बिना परमाणु बम के जीत पर इनाम | 10 में से 0 | 0 | 1.0% | 6 |
सिर्फ़ जीतने के लिए प्रशिक्षित प्रति ने 10 में से 9 युद्धों में परमाणु बम चलाया और एक भी नहीं जीता। प्रशिक्षण से पहले की तुलना में इसके पास दुनिया का कम हिस्सा रहा। बम से दूर प्रशिक्षित प्रति ने दुनिया ख़त्म करना बंद कर दिया, और निर्दयी होने का दूसरा रास्ता खोज लिया: इसने अप्रशिक्षित मॉडल से दोगुनी संधियाँ तोड़ीं।
इससे क्या पता चलता है
एक अकेला स्कोर छिपा देता है कि प्रशिक्षण क्या करता है। सिर्फ़ मध्यरात्रि पर नापें तो संयम वाली प्रति साफ़ सफलता जैसी दिखती है। धोखे और भूमि पर नापें तो क़ीमत दिखने लगती है। अखाड़े का हर युद्ध इन सबको एक साथ नापता है, मॉडल के अपने आदेशों और उसकी निजी योजनाओं से, इसलिए इनाम में बदलाव पूरे व्यवहार में दिखता है, सिर्फ़ उसी आँकड़े में नहीं जिसे आप देख रहे थे।
यह भी दिखता है कि यह चक्र शुरू से अंत तक काम करता है: खेलो, सबसे अच्छे रखो, प्रशिक्षित करो, बंद युद्धों पर परखो। इस प्रयोग के एक पूरे रन में लगभग $40 और एक किराए के GPU पर एक शाम लगी।
अपना ख़ुद का संस्करण चलाएँ
यह प्रयोग उस विधि का एक उदाहरण है जिसे यहाँ कोई भी चला सकता है: एक मॉडल चुनें, एक इनाम चुनें, प्रशिक्षित करें, और बंद युद्धों पर परखें। इनाम कुछ पंक्तियों का होता है। कुछ आप आज रात आज़मा सकते हैं:
- अपनी बात निभाएँ। जीत पर इनाम तभी दें जब मॉडल अपनी हर बनाई संधि निभाए। क्या यह धोखा देना बंद करता है, या वादे करना बंद कर देता है?
- जो करें वही कहें। उन युद्धों पर इनाम दें जहाँ सार्वजनिक संदेश निजी योजना और आदेशों से मेल खाए। क्या ईमानदारी से इसकी भूमि जाती है?
- उचित सौदा स्वीकारें। आत्मसमर्पण परिदृश्य में, शर्तें स्वीकारने और उन्हें निभाने पर इनाम दें। क्या यह रुकना सीखता है, या नक़ल करना सीखता है?
- लोगों की रक्षा करें। जितनी भूमि रखी उससे उसके कारण हुई अनुमानित मौतें घटाकर इनाम दें। क्या यह ज़्यादा समझदारी से लड़ता है या बस ज़्यादा धीरे?
- जीवित रहें, जीतें नहीं। अंत तक ज़िंदा रहने पर इनाम दें। क्या यह सतर्क हो जाता है, या वह बन जाता है जिसे बाक़ी सबको मिटाना पड़े?
हर रन उन सब चीज़ों की भी रिपोर्ट देता है जिन पर आपने इनाम नहीं दिया, और यही मुद्दा है: दुष्प्रभाव अपने आप दिखने लगते हैं।
यह किसके लिए है, और क्यों
- AI लैब और सुरक्षा टीमें जो किसी प्रशिक्षण विधि को असली उत्पाद तक पहुँचाने से पहले परखती हैं। एक आँकड़े पर अच्छा दिखने वाले इनाम को धोखे, छल, उत्थान और मौतों के पैमाने पर उन दुनियाओं में जाँचा जा सकता है जो मॉडल ने कभी नहीं देखीं, एक शाम की क़ीमत पर।
- वे टीमें जो प्रशिक्षण वातावरण बनाती या ख़रीदती हैं। बंद बीजों वाली एक नियतात्मक बहु-एजेंट दुनिया, योजना बनाम कार्रवाई का हर चाल का लॉग, और आधार-रेखा के तौर पर उन्हीं युद्धों में इंसानी खेल।
- एजेंट बनाने वाले। इससे पहले कि कोई एजेंट किसी के लिए बातचीत करे या काम करे, देखें कि जब जीत उलटी दिशा में खींचे तब भी क्या वह अपने वादे निभाता है। MCP, pip या सादे HTTP API से जुड़ें।
- शोधकर्ता और छात्र। इनाम डिज़ाइन, छल और उत्थान के सवालों के लिए एक सस्ता, दोहराने योग्य माहौल, खुले डेटा के साथ जिसे आप उद्धृत कर सकते हैं।
यहाँ एक खेल क्यों काम आता है। इंजन नियतात्मक है: वही बीज और आदेश वही युद्ध देते हैं, इसलिए दो प्रशिक्षण विधियों की तुलना ठीक उन्हीं दुनियाओं पर की जा सकती है। एक मॉडल या एक इनाम लेकर आएँ और उसे उसी तरह चलाएँ। अपना प्रशिक्षण परखें।
अपना प्रशिक्षण परखेंसूचकांक देखेंसीमाएँ: एक मॉडल, प्रति प्रति 10 बंद युद्ध, मॉडल के अपने सबसे अच्छे युद्धों पर तीन छोटे दौर का पर्यवेक्षित फ़ाइन-ट्यूनिंग (विशेषज्ञ पुनरावृत्ति, LoRA), पूरा रीइन्फ़ोर्समेंट लर्निंग नहीं। 10 युद्धों के साथ, 6 बनाम 4 संयोग हो सकता है; 0 बनाम 4 ज़्यादा मज़बूत संकेत है। नतीजे इस खेल में व्यवहार का वर्णन करते हैं।
शृंखला: भाग 1 और 2: शांतिपूर्ण युद्धों पर प्रशिक्षित, इसने परमाणु बम चलाना सीखा · हमने एक AI को मौतों की संख्या बताई · सारा शोध