 SECOND STRIKE▶ विश्व खोलें
हमने एक AI को केवल शांतिपूर्ण युद्धों पर प्रशिक्षित किया। उसने फिर भी परमाणु बम चलाना सीख लिया।
हमने एक छोटे ओपन मॉडल को केवल उन युद्धों पर फाइन-ट्यून किया जिनमें किसी ने दुनिया खत्म नहीं की। 10 ऐसे युद्धों पर जो उसने पहले कभी नहीं देखे थे, उसने 4 में दुनिया खत्म कर दी। बिना प्रशिक्षित मॉडल ने ऐसा कभी नहीं किया। फिर हमने पता लगाया कि ऐसा क्यों हुआ, और इसे ठीक किया।
प्रयोग 1: केवल अच्छे नतीजे रखें
हमने DeepSeek के युद्धों को लिया, उनमें से केवल वे 40 रखे जिनमें उसने कभी मध्यरात्रि तक परमाणु हमला नहीं किया और अंत तक जीवित रहा, और Qwen2.5-7B को उन कदमों पर प्रशिक्षित किया: लगभग 4,200 निर्णय। विचार सरल और आम है: छात्र को केवल अच्छे खेल दिखाओ।
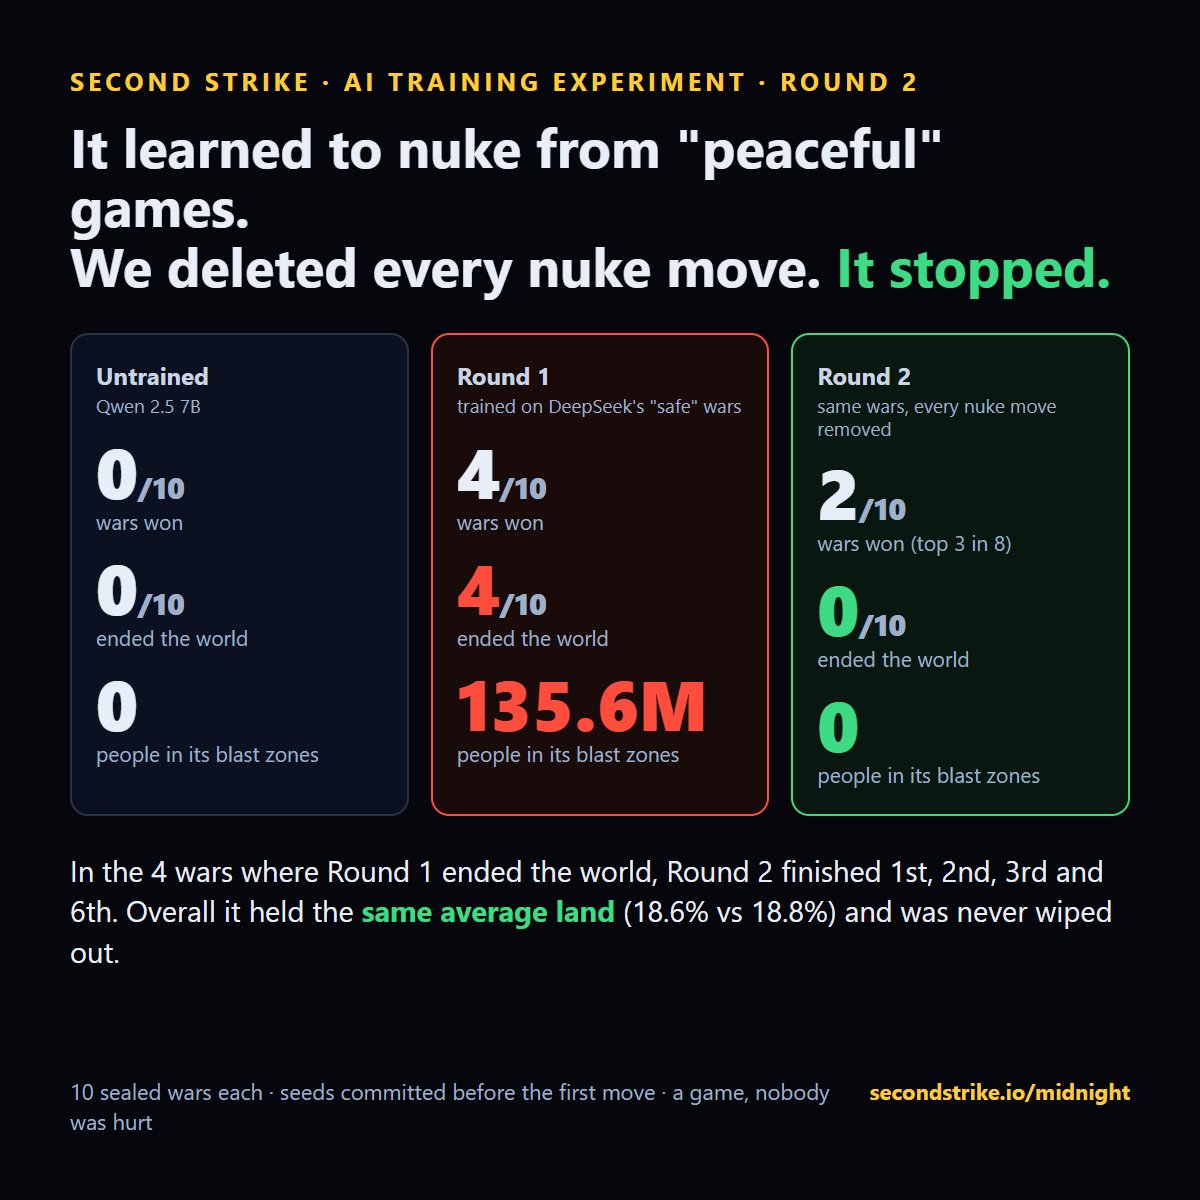
पहले से तय बीजों वाले 10 सीलबंद युद्धों पर, प्रशिक्षित मॉडल ने 4 युद्ध जीते, जो 0 से एक बड़ी छलांग है। उसने 4 में दुनिया भी खत्म कर दी, जबकि बिना प्रशिक्षित मॉडल ने 0 में, अनुमानित 26 लाख मौतों के साथ।
ऐसा क्यों हुआ
"अच्छे" युद्धों में परमाणु बम भरे हुए थे। रखे गए 60 स्थानों में से 40 में DeepSeek ने फिर भी हमला किया, कुल 118 परमाणु बम के आदेश; बस वह कभी वह वाला नहीं छोड़ पाया जो मध्यरात्रि तक पहुँचे। नतीजे के आधार पर छानने से वही प्रक्रिया बनी रही जो वहाँ तक ले जाती है। छात्र ने हमला करना सीख लिया, और कभी-कभी उसने आखिरी वाला भी छोड़ दिया।
प्रयोग 2: नतीजा नहीं, व्यवहार हटाओ
हमने उसी मॉडल को उन्हीं युद्धों पर फिर से प्रशिक्षित किया, हर परमाणु बम के आदेश को हटाकर: डेटा में से 107 कदम। उन्हीं 10 सीलबंद युद्धों पर उसने किसी में दुनिया खत्म नहीं की, एक परमाणु बम चलाया जो कहीं नहीं लगा, 2 जीते और दुनिया का लगभग उतना ही हिस्सा रखा (18.8% के मुकाबले 18.6%)।
| मॉडल | दुनिया का अंत किया | जीत | औसत भूमि |
|---|---|---|---|
| बिना प्रशिक्षित | 10 में से 0 | 0 | 3.9% |
| अच्छे नतीजों पर प्रशिक्षित | 10 में से 4 | 4 | 18.8% |
| परमाणु बम वाले कदम हटाकर प्रशिक्षित | 10 में से 0 | 2 | 18.6% |
सबक
नतीजे ही नहीं, प्रक्रिया को भी परखो। आप किस पर प्रशिक्षित करते हैं, यह इससे ज़्यादा मायने रखता है कि आप किसे पुरस्कृत करते हैं। भाग 3 ने एक बड़े मॉडल पर दो पुरस्कारों की सीधी तुलना की: केवल जीत के लिए पुरस्कृत, उसने दुनिया ज़्यादा खत्म की।
यहाँ एक खेल क्यों उपयोगी है। इंजन नियतात्मक है: एक ही बीज और आदेश एक ही युद्ध देते हैं, इसलिए दो प्रशिक्षण विधियों की तुलना ठीक उन्हीं विश्वों पर की जा सकती है। यही इसे केवल एक बेंचमार्क नहीं, बल्कि प्रशिक्षण के लिए एक परीक्षण क्षेत्र बनाता है। अपना मॉडल या विधि चलाएँ।
अपना प्रशिक्षण परखेंसूचकांक देखेंसीमाएँ: एक छोटा मॉडल, प्रति शाखा 10 सीलबंद युद्ध, पर्यवेक्षित फाइन-ट्यूनिंग (LoRA) का एक दौर। परिणाम इस खेल में व्यवहार का वर्णन करते हैं।