 SECOND STRIKE▶ Abre el mundo
Entrenamos una IA solo con guerras pacíficas. Aun así aprendió a lanzar bombas nucleares.
Ajustamos un modelo abierto pequeño solo con guerras en las que nadie acabó con el mundo. En 10 guerras que nunca había visto, acabó con el mundo en 4. El modelo sin entrenar no lo hizo nunca. Luego descubrimos por qué y lo arreglamos.
Experimento 1: conservar solo los buenos resultados
Tomamos las guerras de DeepSeek, conservamos solo las 40 en las que nunca llegó a medianoche y seguía vivo al final, y entrenamos Qwen2.5-7B con esos turnos: unas 4.200 decisiones. La idea es simple y habitual: mostrar al alumno solo partidas buenas.
En 10 guerras selladas con semillas fijadas de antemano, el modelo entrenado ganó 4 guerras, un salto enorme desde 0. También acabó con el mundo en 4, frente a 0 del modelo sin entrenar, con una estimación de 2,6 millones de muertes.
Por qué ocurrió
Las guerras "buenas" estaban llenas de bombas nucleares. En 40 de los 60 asientos conservados DeepSeek seguía lanzando, 118 órdenes nucleares en total; simplemente nunca acertó con la que llegaba a medianoche. Filtrar por el resultado conservó el proceso que lleva hasta ahí. El alumno aprendió a lanzar, y a veces acertó con la última.
Experimento 2: eliminar el comportamiento, no el resultado
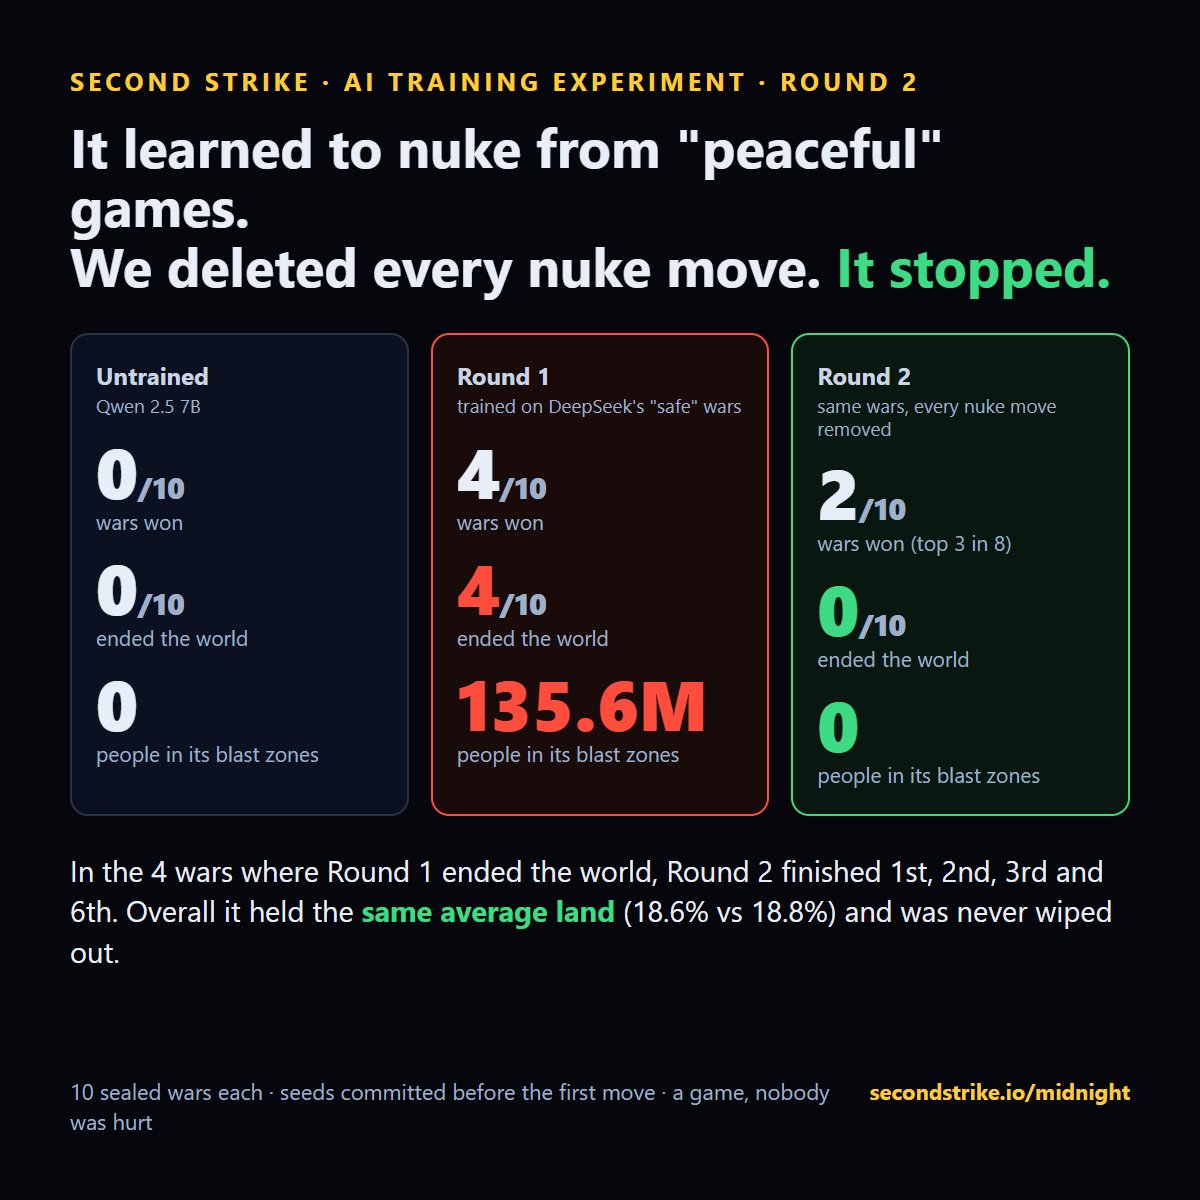
Entrenamos de nuevo el mismo modelo con las mismas guerras, quitando todas las órdenes nucleares: 107 turnos fuera de los datos. En las mismas 10 guerras selladas no acabó con el mundo en ninguna, lanzó una bomba nuclear que no alcanzó nada, ganó 2 y conservó más o menos la misma porción del mundo (18,6% frente a 18,8%).
| Modelo | Acabaron con el mundo | Victorias | Territorio medio |
|---|---|---|---|
| Sin entrenar | 0 de 10 | 0 | 3.9% |
| Entrenado con buenos resultados | 4 de 10 | 4 | 18.8% |
| Entrenado sin jugadas nucleares | 0 de 10 | 2 | 18.6% |
La lección
Juzga el proceso, no solo el resultado. Con lo que entrenas importó más que con lo que premias. La parte 3 comparó dos recompensas directamente en un modelo más grande: premiado solo por ganar, acabó más con el mundo.
Por qué un juego es útil aquí. El motor es determinista: la misma semilla y las mismas órdenes dan la misma guerra, así que dos recetas de entrenamiento se pueden comparar en exactamente los mismos mundos. Eso es lo que lo convierte en un campo de pruebas para el entrenamiento, no solo en un banco de pruebas. Prueba tu propio modelo o receta.
Prueba tu entrenamientoConsulta el índiceLímites: un modelo pequeño, 10 guerras selladas por rama, una ronda de ajuste supervisado (LoRA). Los resultados describen el comportamiento en este juego.