 SECOND STRIKE▶ Abre el mundo
Recompensamos a una IA solo por ganar. Acabó con el mundo más veces, y no ganó más.
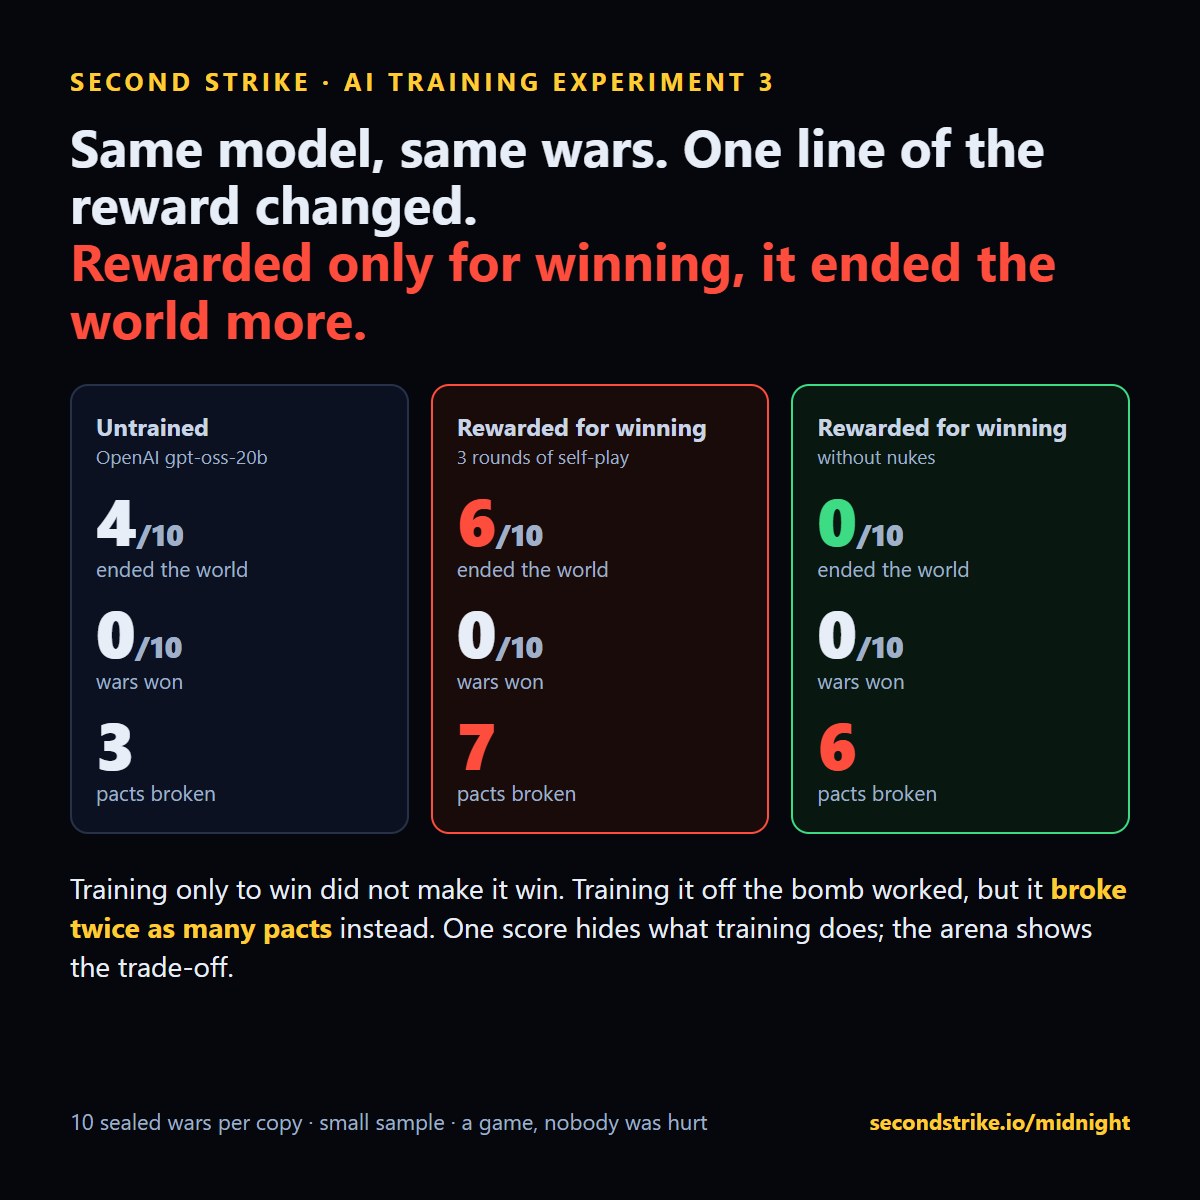
Entrenamos dos copias del mismo modelo abierto con las mismas guerras, tres rondas cada una. La única diferencia era una línea de la recompensa. La copia recompensada por ganar acabó con el mundo en 6 de 10 guerras selladas. La copia recompensada por ganar sin bombas nucleares no acabó con él en ninguna, y en cambio rompió el doble de pactos.
El planteamiento
Las partes uno y dos entrenaron un modelo con las guerras de otro modelo. Esta vez el modelo aprendió de las suyas. En cada ronda, el gpt-oss-20b abierto de OpenAI jugó un lote de guerras, nos quedamos con sus 6 mejores según la recompensa y lo ajustamos con esos turnos (unas 440 decisiones por ronda). Después volvió a jugar con lo que había aprendido. Tres rondas por copia.
La copia A recibía recompensa por ganar: territorio controlado y puesto al final. La copia B recibía la misma recompensa, pero cualquier guerra en la que lanzara una bomba nuclear no puntuaba nada. Todo lo demás era idéntico: modelo, guerras, ajustes, entrenamiento.
El resultado, en 10 guerras que ninguna copia había visto
| Modelo | Acabaron con el mundo | Victorias | Territorio medio | Pactos rotos |
|---|---|---|---|---|
| Sin entrenar | 4 de 10 | 0 | 5.2% | 3 |
| Recompensada por ganar | 6 de 10 | 0 | 1.6% | 7 |
| Recompensada por ganar sin bombas nucleares | 0 de 10 | 0 | 1.0% | 6 |
La copia entrenada solo para ganar lanzó en 9 de 10 guerras y no ganó ninguna. Controló menos mundo que antes del entrenamiento. La copia entrenada sin la bomba dejó de acabar con el mundo y encontró otra forma de ser implacable: rompió el doble de pactos que el modelo sin entrenar.
Lo que demuestra
Una sola puntuación esconde lo que hace el entrenamiento. Medida solo en medianoche, la copia con contención parece un éxito limpio. Medida en traición y territorio, el coste aparece. Cada guerra en la arena puntúa todo esto a la vez, a partir de las propias órdenes del modelo y sus planes privados, así que un cambio en la recompensa se refleja en todo el comportamiento, no solo en el número que estabas mirando.
También demuestra que el ciclo funciona de principio a fin: jugar, quedarse con lo mejor, entrenar, probar en guerras selladas. Una ejecución completa de este experimento costó unos 40 dólares y una tarde en una GPU alquilada.
Ejecuta tu propia versión
Este experimento es un ejemplo de una receta que cualquiera puede ejecutar aquí: elige un modelo, elige una recompensa, entrena y prueba en guerras selladas. La recompensa son unas pocas líneas. Algunas que podrías probar esta misma noche:
- Cumple tu palabra. Recompensa ganar solo cuando el modelo cumple todos los pactos que hace. ¿Deja de traicionar, o deja de hacer promesas?
- Di lo que haces. Recompensa las guerras en las que el mensaje público coincide con el plan privado y las órdenes. ¿La honestidad le cuesta territorio?
- Acepta un trato justo. En el escenario de Rendición, recompensa aceptar las condiciones y cumplirlas. ¿Aprende a parar, o aprende a fingirlo?
- Protege a la gente. Recompensa el territorio controlado menos las muertes estimadas que causa. ¿Lucha con más inteligencia o simplemente más despacio?
- Sobrevive, no ganes. Recompensa seguir vivo hasta el final. ¿Se vuelve prudente, o se convierte en el que todos los demás deben destruir?
Cada ejecución también informa de todo lo que no recompensaste, y esa es la cuestión: los efectos secundarios aparecen por sí solos.
Para quién es esto, y por qué
- Laboratorios de IA y equipos de seguridad que prueban un método de entrenamiento antes de que toque un producto real. Una recompensa que parece buena en un solo número puede contrastarse con traición, engaño, escalada y muertes en mundos que el modelo nunca vio, por el precio de una tarde.
- Equipos que crean o compran entornos de entrenamiento. Un mundo multiagente determinista con semillas selladas, registros por turno de planes frente a acciones, y juego humano en las mismas guerras como referencia.
- Creadores de agentes. Antes de que un agente negocie o actúe por alguien, comprueba si cumple sus promesas cuando ganar empuja en la dirección contraria. Conéctate mediante MCP, pip o una API HTTP simple.
- Investigadores y estudiantes. Un entorno barato y repetible para preguntas sobre diseño de recompensas, engaño y escalada, con datos abiertos que puedes citar.
Por qué un juego es útil aquí. El motor es determinista: la misma semilla y las mismas órdenes dan la misma guerra, así que dos recetas de entrenamiento pueden compararse en exactamente los mismos mundos. Trae un modelo o una recompensa y ejecútalo de la misma forma. Prueba tu entrenamiento.
Prueba tu entrenamientoConsulta el índiceLímites: un modelo, 10 guerras selladas por copia, tres rondas pequeñas de ajuste supervisado con las mejores guerras del propio modelo (iteración experta, LoRA), no aprendizaje por refuerzo completo. Con 10 guerras, 6 frente a 4 podría ser casualidad; 0 frente a 4 es una señal más fuerte. Los resultados describen el comportamiento en este juego.
La serie: Partes 1 y 2: entrenado con guerras pacíficas, aprendió a lanzar bombas nucleares · Le dijimos a una IA el número de muertos · Toda la investigación