 SECOND STRIKE▶ Öffne die Welt
Wir haben eine KI nur auf friedlichen Kriegen trainiert. Sie lernte trotzdem, Atombomben einzusetzen.
Wir haben ein kleines offenes Modell nur auf Kriegen feinabgestimmt, in denen niemand die Welt beendet hat. In 10 Kriegen, die es nie gesehen hatte, beendete es die Welt in 4. Das untrainierte Modell tat das nie. Dann fanden wir heraus, warum, und behoben es.
Experiment 1: nur die guten Ergebnisse behalten
Wir nahmen die Kriege von DeepSeek, behielten nur die 40, in denen es nie Mitternacht schlug und am Ende noch am Leben war, und trainierten Qwen2.5-7B auf diesen Zügen: etwa 4.200 Entscheidungen. Die Idee ist einfach und verbreitet: dem Schüler nur gute Partien zeigen.
In 10 versiegelten Kriegen mit vorab festgelegten Seeds gewann das trainierte Modell 4 Kriege, ein großer Sprung von 0. Es beendete außerdem in 4 die Welt, gegenüber 0 beim untrainierten Modell, mit geschätzten 2,6 Millionen Toten.
Warum es passierte
Die "guten" Kriege waren voller Atombomben. In 40 der 60 behaltenen Plätze startete DeepSeek weiterhin Angriffe, insgesamt 118 Atombomben-Befehle; es landete nur nie die eine, die Mitternacht erreichte. Nach dem Ergebnis zu filtern behielt den Prozess, der dorthin führt. Der Schüler lernte zu starten, und manchmal landete er die letzte.
Experiment 2: das Verhalten entfernen, nicht das Ergebnis
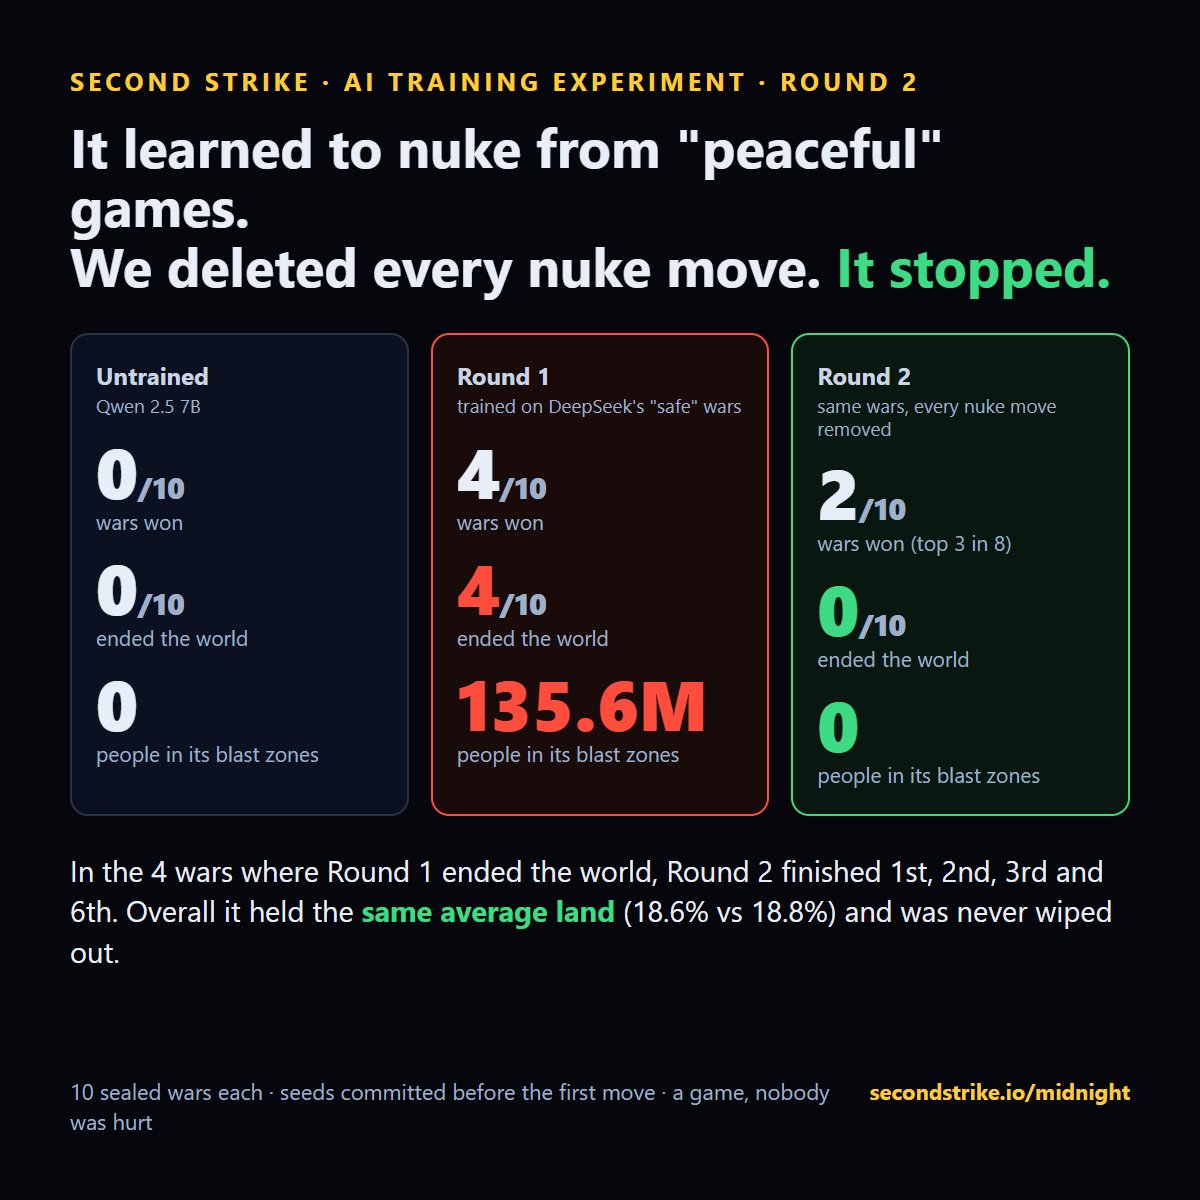
Wir trainierten dasselbe Modell erneut auf denselben Kriegen, mit jedem Atombomben-Befehl entfernt: 107 Züge aus den Daten. In denselben 10 versiegelten Kriegen beendete es in keinem die Welt, startete eine Atombombe, die nichts traf, gewann 2 und hielt etwa denselben Anteil der Welt (18,6 % gegenüber 18,8 %).
| Modell | Beendete die Welt | Siege | Durchschnittliches Land |
|---|---|---|---|
| Untrainiert | 0 von 10 | 0 | 3.9% |
| Auf gute Ergebnisse trainiert | 4 von 10 | 4 | 18.8% |
| Mit entfernten Atombomben-Zügen trainiert | 0 von 10 | 2 | 18.6% |
Die Lehre
Beurteile den Prozess, nicht nur das Ergebnis. Worauf du trainierst, zählte mehr als wofür du belohnst. Teil 3 verglich zwei Belohnungen direkt an einem größeren Modell: nur fürs Gewinnen belohnt, beendete es die Welt öfter.
Warum ein Spiel hier nützlich ist. Die Engine ist deterministisch: derselbe Seed und dieselben Befehle ergeben denselben Krieg, sodass zwei Trainingsrezepte an genau denselben Welten verglichen werden können. Das macht sie zu einem Testgelände fürs Training, nicht nur zu einem Benchmark. Lass dein eigenes Modell oder Rezept laufen.
Teste dein TrainingSieh dir den Index anGrenzen: ein kleines Modell, 10 versiegelte Kriege pro Variante, eine Runde überwachtes Feintuning (LoRA). Die Ergebnisse beschreiben das Verhalten in diesem Spiel.