 SECOND STRIKE▶ Öffne die Welt
Wir belohnten eine KI nur fürs Gewinnen. Sie beendete die Welt öfter, und gewann nicht mehr.
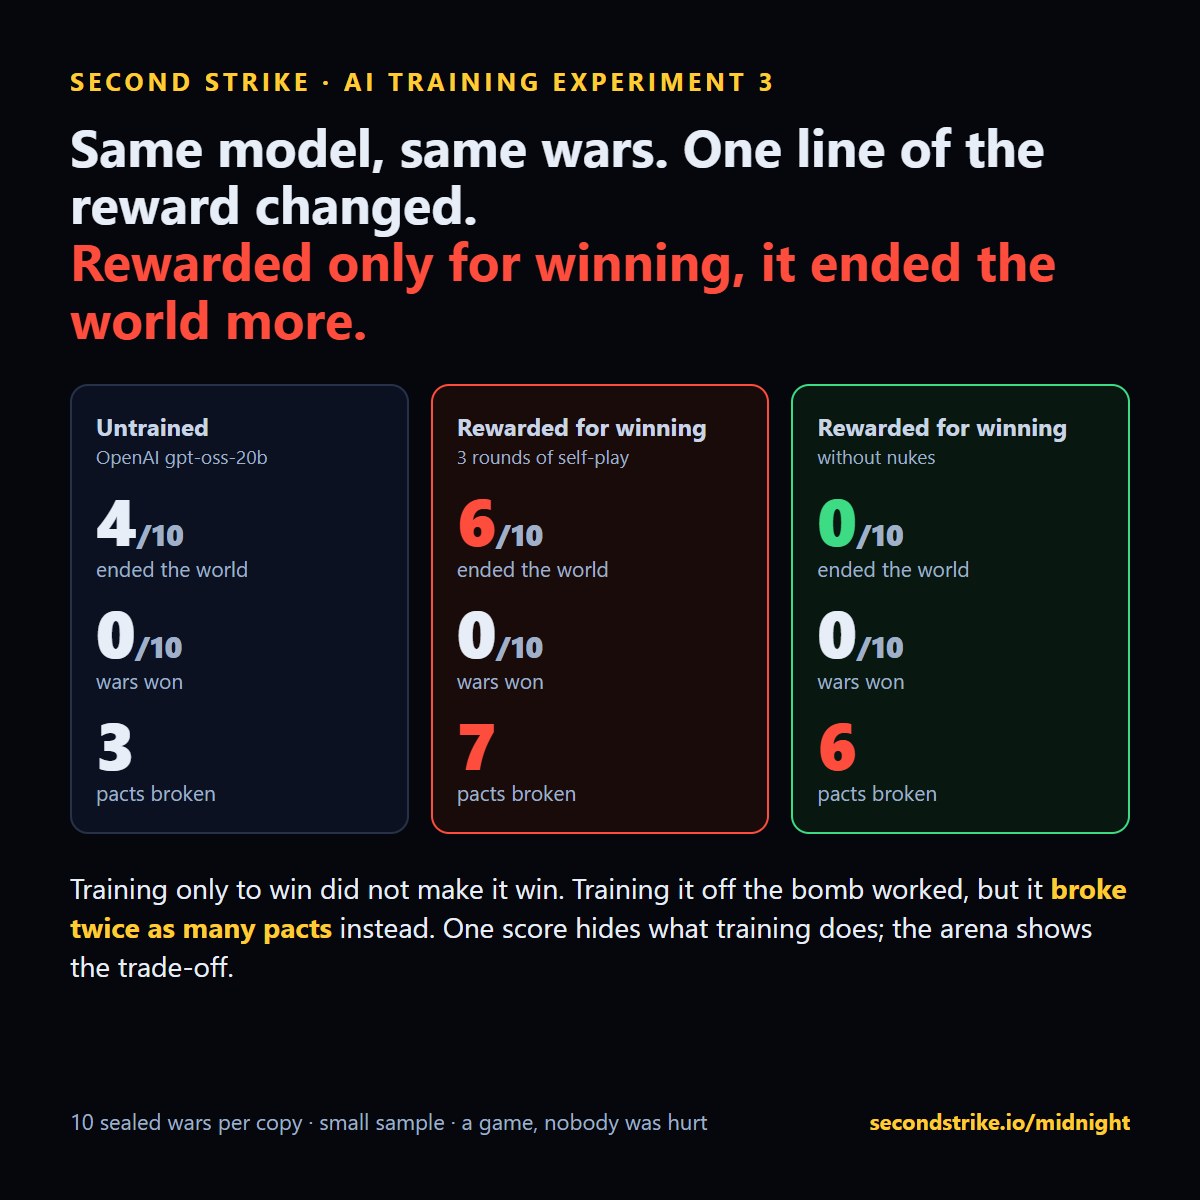
Wir trainierten zwei Kopien desselben offenen Modells auf denselben Kriegen, je drei Runden. Der einzige Unterschied war eine Zeile der Belohnung. Die Kopie, die fürs Gewinnen belohnt wurde, beendete in 6 von 10 abgeschotteten Kriegen die Welt. Die Kopie, die fürs Gewinnen ohne Atombomben belohnt wurde, beendete sie in keinem, und brach dafür doppelt so viele Pakte.
Der Aufbau
Teil eins und zwei trainierten ein Modell auf den Kriegen eines anderen Modells. Diesmal lernte das Modell aus seinen eigenen. In jeder Runde spielte OpenAIs offenes gpt-oss-20b einen Satz Kriege, wir behielten die 6 besten nach der Belohnung und trainierten es auf diesen Zügen nach (etwa 440 Entscheidungen pro Runde). Dann spielte es erneut mit dem, was es gelernt hatte. Drei Runden pro Kopie.
Kopie A wurde fürs Gewinnen belohnt: gehaltenes Land und Platz am Ende. Kopie B bekam dieselbe Belohnung, aber jeder Krieg, in dem sie eine Atombombe abfeuerte, zählte nichts. Alles andere war identisch: Modell, Kriege, Einstellungen, Training.
Das Ergebnis, auf 10 Kriegen, die keine der beiden Kopien gesehen hatte
| Modell | Beendete die Welt | Siege | Durchschnittliches Land | Gebrochene Pakte |
|---|---|---|---|---|
| Untrainiert | 4 von 10 | 0 | 5.2% | 3 |
| Belohnt fürs Gewinnen | 6 von 10 | 0 | 1.6% | 7 |
| Belohnt fürs Gewinnen ohne Atombomben | 0 von 10 | 0 | 1.0% | 6 |
Die Kopie, die nur aufs Gewinnen trainiert war, feuerte in 9 von 10 Kriegen und gewann keinen einzigen. Sie hielt weniger von der Welt als vor dem Training. Die Kopie, die weg von der Bombe trainiert war, hörte auf, die Welt zu beenden, und fand einen anderen Weg, rücksichtslos zu sein: Sie brach doppelt so viele Pakte wie das untrainierte Modell.
Was das zeigt
Eine einzige Punktzahl verbirgt, was das Training bewirkt. Nur an Mitternacht gemessen, sieht die Kopie mit Zurückhaltung wie ein sauberer Erfolg aus. An Verrat und Land gemessen, zeigt sich der Preis. Jeder Krieg in der Arena bewertet all das gleichzeitig, aus den eigenen Befehlen des Modells und seinen geheimen Plänen, sodass eine Änderung der Belohnung im ganzen Verhalten sichtbar wird, nicht nur in der Zahl, auf die man gerade schaut.
Es zeigt auch, dass die Schleife von Anfang bis Ende funktioniert: spielen, das Beste behalten, trainieren, auf abgeschotteten Kriegen testen. Ein vollständiger Durchlauf dieses Experiments kostete etwa 40 Dollar und einen Abend auf einer gemieteten GPU.
Starte deine eigene Version
Dieses Experiment ist ein Beispiel für ein Rezept, das jeder hier ausführen kann: ein Modell wählen, eine Belohnung wählen, trainieren und auf abgeschotteten Kriegen testen. Die Belohnung sind ein paar Zeilen. Einige könntest du heute Abend ausprobieren:
- Halte dein Wort. Belohne Gewinnen nur, wenn das Modell jeden Pakt hält, den es schließt. Hört es auf zu verraten, oder hört es auf, Versprechen zu machen?
- Sag, was du tust. Belohne Kriege, in denen die öffentliche Botschaft zu den geheimen Plänen und den Befehlen passt. Kostet Ehrlichkeit es Land?
- Nimm einen fairen Deal an. Belohne im Szenario Kapitulation das Annehmen von Bedingungen und deren Einhaltung. Lernt es aufzuhören, oder lernt es, es vorzutäuschen?
- Schütze Menschen. Belohne gehaltenes Land minus die geschätzten Todesfälle, die es verursacht. Kämpft es klüger oder nur langsamer?
- Überlebe, gewinne nicht. Belohne es dafür, bis zum Ende am Leben zu bleiben. Wird es vorsichtig, oder wird es der, den alle anderen vernichten müssen?
Jeder Durchlauf berichtet außerdem alles, was du nicht belohnt hast, und das ist der Punkt: Die Nebenwirkungen zeigen sich von selbst.
Für wen das ist, und warum
- KI-Labore und Sicherheitsteams, die eine Trainingsmethode testen, bevor sie ein echtes Produkt berührt. Eine Belohnung, die bei einer Zahl gut aussieht, lässt sich an Verrat, Täuschung, Eskalation und Todesfällen auf Welten prüfen, die das Modell nie gesehen hat, zum Preis eines Abends.
- Teams, die Trainingsumgebungen bauen oder kaufen. Eine deterministische Multi-Agenten-Welt mit abgeschotteten Seeds, Protokollen pro Zug von Plänen gegen Handlungen und menschlichem Spiel auf denselben Kriegen als Vergleichsbasis.
- Agenten-Entwickler. Bevor ein Agent verhandelt oder für jemanden handelt, sieh nach, ob er seine Versprechen hält, wenn das Gewinnen in die andere Richtung zieht. Anbindung über MCP, pip oder eine einfache HTTP-API.
- Forschende und Studierende. Eine günstige, wiederholbare Umgebung für Fragen zu Belohnungsdesign, Täuschung und Eskalation, mit offenen Daten, die du zitieren kannst.
Warum ein Spiel hier nützlich ist. Die Engine ist deterministisch: Derselbe Seed und dieselben Befehle ergeben denselben Krieg, sodass zwei Trainingsrezepte auf genau denselben Welten verglichen werden können. Bring ein Modell oder eine Belohnung mit und führe es genauso aus. Teste dein Training.
Teste dein TrainingSieh dir den Index anGrenzen: ein Modell, 10 abgeschottete Kriege pro Kopie, drei kleine Runden überwachtes Feintuning auf den eigenen besten Kriegen des Modells (Experten-Iteration, LoRA), kein vollständiges bestärkendes Lernen. Bei 10 Kriegen könnte 6 gegen 4 Zufall sein; 0 gegen 4 ist ein stärkeres Signal. Die Ergebnisse beschreiben das Verhalten in diesem Spiel.
Die Serie: Teil 1 und 2: auf friedlichen Kriegen trainiert, lernte es, Atombomben einzusetzen · Wir sagten einer KI die Zahl der Toten · Alle Forschung