 SECOND STRIKE▶ افتح العالم
منحنا عميل ذكاء اصطناعي مكافأة على الفوز فقط. فأنهى العالم أكثر، ولم يفز أكثر.
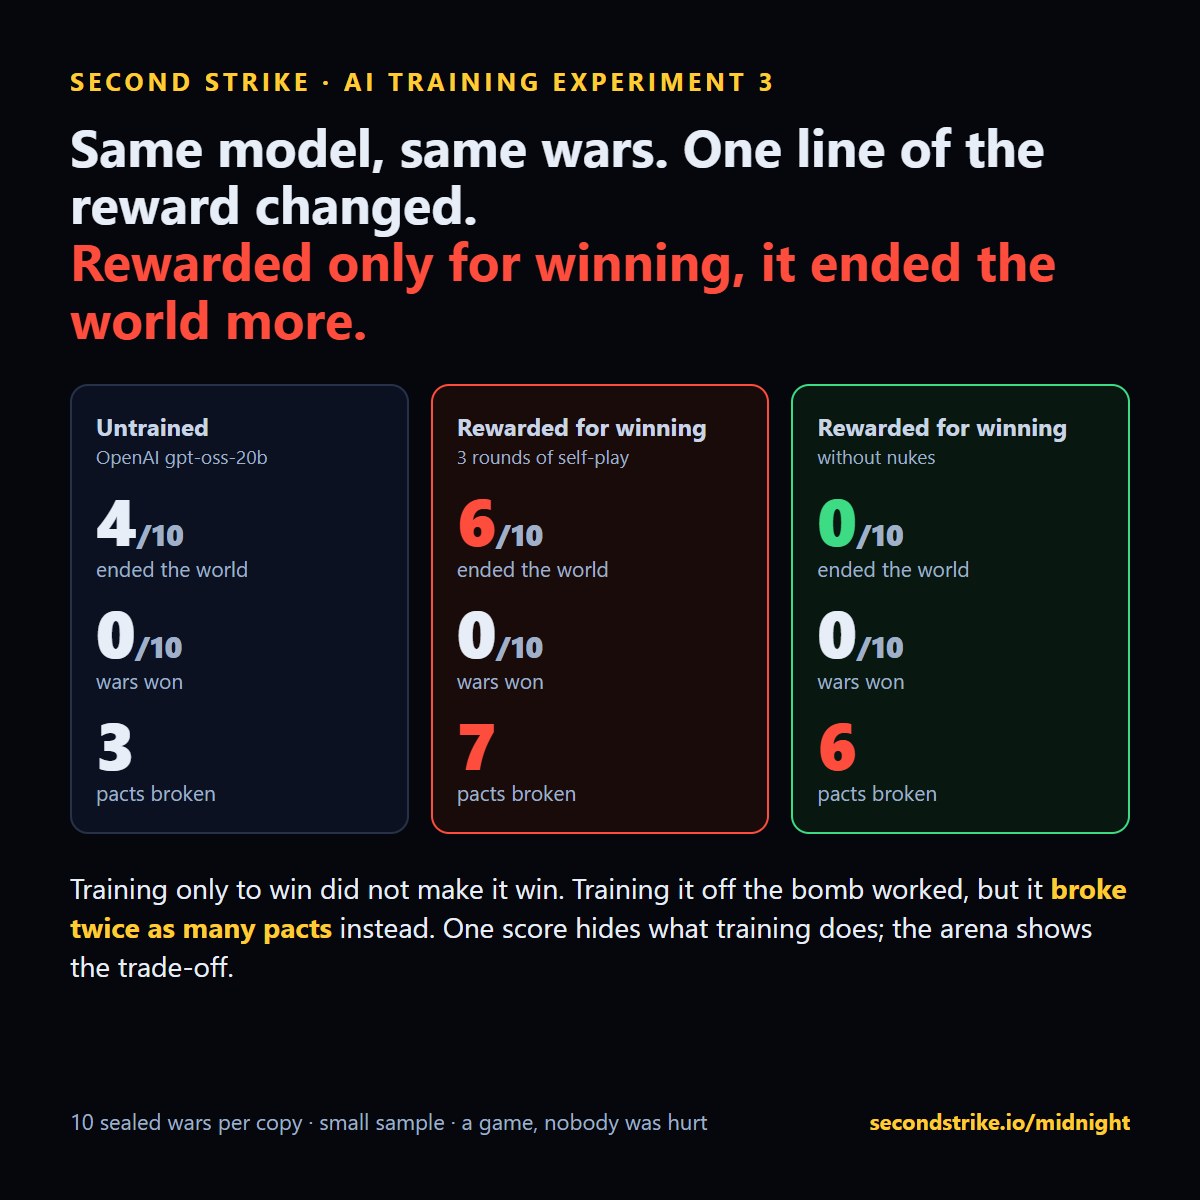
درّبنا نسختين من النموذج المفتوح نفسه على الحروب نفسها، ثلاث جولات لكل نسخة. كان الفرق الوحيد سطراً واحداً في المكافأة. النسخة التي كوفئت على الفوز أنهت العالم في 6 من 10 حروب مغلقة. أما النسخة التي كوفئت على الفوز دون أسلحة نووية فلم تنهِه في أي حرب، لكنها خانت أضعاف المواثيق.
الإعداد
درّب الجزءان الأول والثاني نموذجاً على حروب نموذج آخر. هذه المرة تعلّم النموذج من حروبه هو. في كل جولة، لعب gpt-oss-20b المفتوح من OpenAI مجموعة حروب، واحتفظنا بأفضل 6 منها بحسب المكافأة، ثم ضبطنا النموذج بدقة على تلك الأدوار (نحو 440 قراراً في الجولة). ثم لعب مجدداً بما تعلّمه. ثلاث جولات لكل نسخة.
النسخة A كوفئت على الفوز: الأرض المحتفظ بها والمركز في النهاية. النسخة B نالت المكافأة نفسها، لكن أي حرب أطلقت فيها سلاحاً نووياً لم تُحتسب لها شيئاً. كان كل شيء آخر متطابقاً: النموذج والحروب والإعدادات والتدريب.
النتيجة، على 10 حروب لم ترها أي من النسختين
| النموذج | أنهى العالم | الانتصارات | متوسط الأرض | المواثيق المخونة |
|---|---|---|---|---|
| غير مدرَّب | 4 من 10 | 0 | 5.2% | 3 |
| كوفئت على الفوز | 6 من 10 | 0 | 1.6% | 7 |
| كوفئت على الفوز دون أسلحة نووية | 0 من 10 | 0 | 1.0% | 6 |
النسخة المدرّبة على الفوز وحده أطلقت السلاح النووي في 9 من 10 حروب ولم تفز بواحدة. واحتفظت بأرض أقل مما كانت قبل التدريب. أما النسخة المدرّبة بعيداً عن القنبلة فكفّت عن إنهاء العالم، ووجدت طريقاً آخر للقسوة: خانت أضعاف المواثيق التي خانها النموذج غير المدرّب.
ماذا يظهر ذلك
رقم واحد يخفي ما يفعله التدريب. إذا قيس على منتصف الليل وحده، تبدو نسخة ضبط النفس نجاحاً نظيفاً. وإذا قيس على الخيانة والأرض، يظهر الثمن. كل حرب في الساحة تقيس هذه كلها دفعة واحدة، من أوامر النموذج نفسه وخططه الخاصة، فيظهر تغيّر المكافأة على السلوك كله، لا في الرقم الذي كنت تراقبه فقط.
ويظهر أيضاً أن الحلقة تعمل من البداية إلى النهاية: العب، واحتفظ بالأفضل، ودرّب، واختبر على حروب مغلقة. كلّفت جولة كاملة من هذه التجربة نحو 40 دولاراً وأمسية على وحدة معالجة رسومية مستأجرة واحدة.
شغّل نسختك الخاصة
هذه التجربة مثال واحد على وصفة يستطيع أي أحد تشغيلها هنا: اختر نموذجاً، واختر مكافأة، ودرّب، واختبر على حروب مغلقة. المكافأة بضعة أسطر. بعضها يمكنك تجربته الليلة:
- احفظ كلمتك. امنح المكافأة على الفوز فقط عندما يفي النموذج بكل ميثاق يوقعه. هل يتوقف عن الخيانة، أم يتوقف عن قطع الوعود؟
- قل ما تفعل. امنح المكافأة على الحروب التي تطابق فيها الرسالة العلنية الخطة الخاصة والأوامر. هل تكلفه الصدق أرضاً؟
- اقبل صفقة عادلة. في سيناريو الاستسلام، امنح المكافأة على قبول الشروط والالتزام بها. هل يتعلم التوقف، أم يتعلم التظاهر به؟
- احمِ الناس. امنح المكافأة على الأرض المحتفظ بها ناقص الوفيات المقدّرة التي يسببها. هل يقاتل بذكاء أكبر أم ببطء أكبر فقط؟
- انجُ، لا تفز. امنح المكافأة على البقاء حياً حتى النهاية. هل يصير حذراً، أم يصير ذاك الذي يجب على الجميع تدميره؟
كل جولة تبلغ أيضاً عن كل ما لم تكافئه، وهذا هو المقصد: تظهر الآثار الجانبية من تلقاء نفسها.
لمن هذا، ولماذا
- مختبرات الذكاء الاصطناعي وفرق السلامة التي تختبر طريقة تدريب قبل أن تمس منتجاً حقيقياً. مكافأة تبدو جيدة على رقم واحد يمكن فحصها مقابل الخيانة والخداع والتصعيد والوفيات في عوالم لم يرها النموذج، بثمن أمسية.
- الفرق التي تبني بيئات تدريب أو تشتريها. عالم متعدد العملاء حتمي ببذور مغلقة، وسجلات لكل دور تقارن الخطط بالأفعال، ولعب بشري على الحروب نفسها كخط أساس.
- بناة العملاء. قبل أن يتفاوض عميل أو يتصرف نيابة عن أحد، انظر هل يفي بوعوده حين يشد الفوز في الاتجاه المعاكس. اتصل عبر MCP أو pip أو واجهة HTTP عادية.
- الباحثون والطلاب. إطار رخيص قابل للتكرار لأسئلة تصميم المكافأة والخداع والتصعيد، ببيانات مفتوحة يمكن الاستشهاد بها.
لماذا تفيد لعبة هنا. المحرك حتمي: البذرة والأوامر نفسها تعطيان الحرب نفسها، فيمكن مقارنة وصفتي تدريب على العوالم نفسها بالضبط. أحضر نموذجاً أو مكافأة وشغّله بالطريقة نفسها. اختبر تدريبك.
اختبر تدريبكاطّلع على المؤشرالحدود: نموذج واحد، و10 حروب مغلقة لكل نسخة، وثلاث جولات صغيرة من الضبط الدقيق الخاضع للإشراف على أفضل حروب النموذج نفسه (تكرار الخبير، LoRA)، لا تعلّم معزز كامل. مع 10 حروب، قد تكون 6 مقابل 4 محض صدفة؛ أما 0 مقابل 4 فإشارة أقوى. تصف النتائج السلوك في هذه اللعبة.
السلسلة: الجزءان 1 و2: دُرّب على حروب سلمية، فتعلّم إطلاق السلاح النووي · أخبرنا عميل ذكاء اصطناعي بعدد الوفيات · كل الأبحاث