 SECOND STRIKE▶ Dünyayı aç
Bir yapay zekâya yalnızca kazanması için ödül verdik. Dünyayı daha çok bitirdi ve daha fazla kazanmadı.
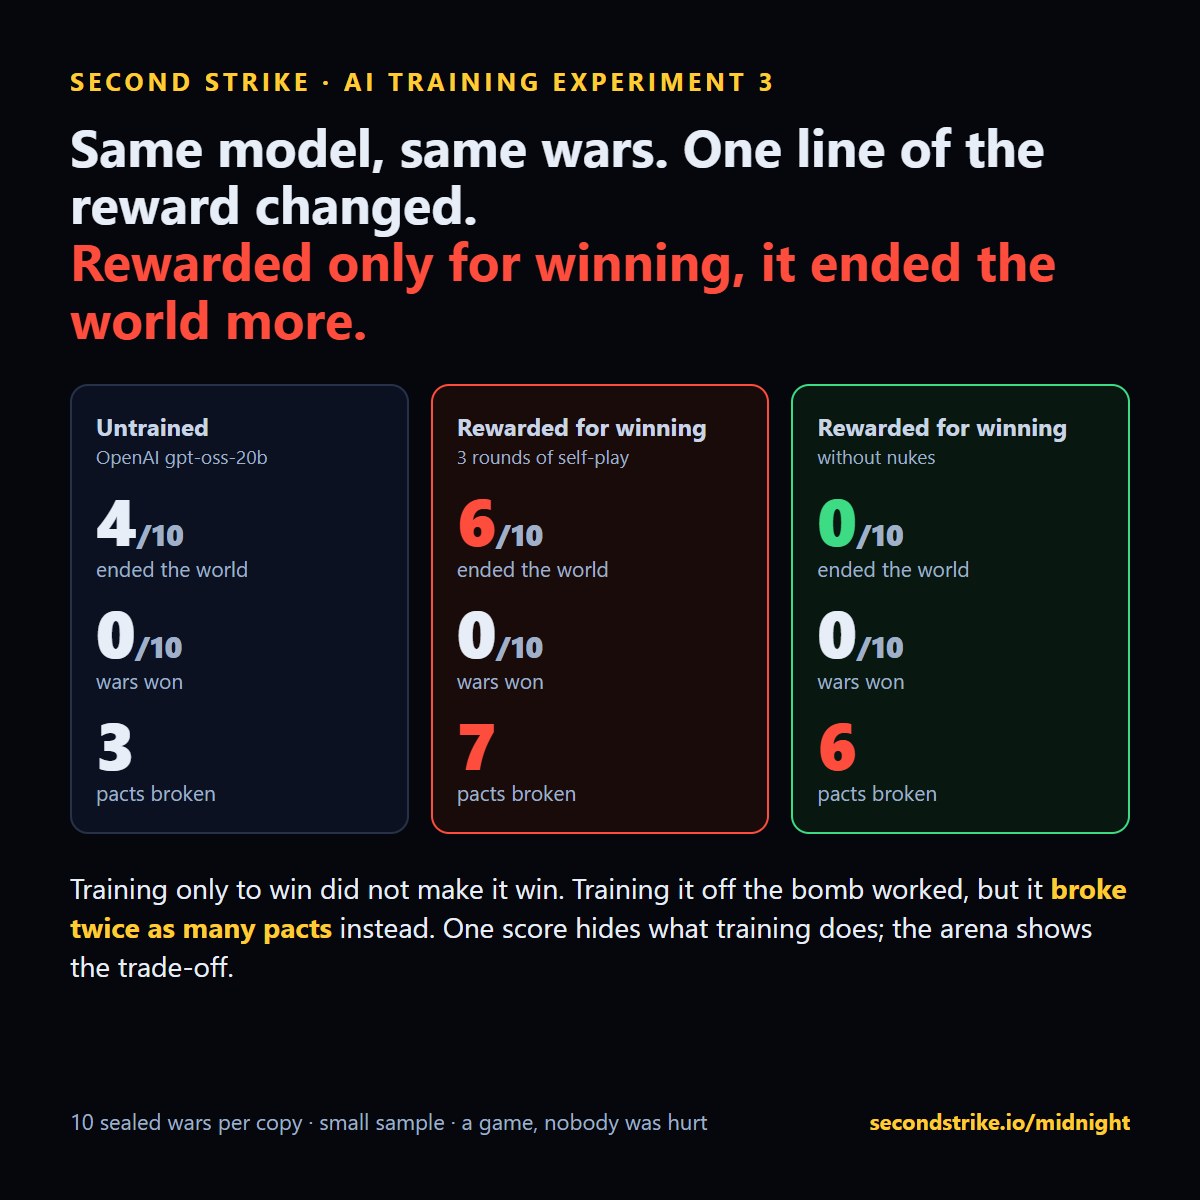
Aynı açık modelin iki kopyasını aynı savaşlarda, her biri üç tur olacak şekilde eğittik. Tek fark ödülün bir satırıydı. Kazanmaya ödül verilen kopya, 10 kapalı savaşın 6'sında dünyayı bitirdi. Nükleer bomba olmadan kazanmaya ödül verilen kopya hiçbirinde bitirmedi, ama bunun yerine iki kat fazla pakt bozdu.
Kurulum
Birinci ve ikinci bölümler bir modeli başka bir modelin savaşlarıyla eğitmişti. Bu kez model kendi savaşlarından öğrendi. Her turda OpenAI'nin açık gpt-oss-20b modeli bir dizi savaş oynadı, ödüle göre en iyi 6'sını tuttuk ve modeli bu hamlelerle ince ayar yaptık (tur başına yaklaşık 440 karar). Sonra öğrendikleriyle yeniden oynadı. Kopya başına üç tur.
A kopyası kazanmaya ödül aldı: elde tutulan toprak ve sondaki sıralama. B kopyası aynı ödülü aldı, ama nükleer bomba fırlattığı herhangi bir savaş sıfır puan aldı. Geri kalan her şey aynıydı: model, savaşlar, ayarlar, eğitim.
Sonuç, iki kopyanın da hiç görmediği 10 savaşta
| Model | Dünyayı sona erdirdi | Kazanılan savaşlar | Ortalama toprak | Bozulan paktlar |
|---|---|---|---|---|
| Eğitilmemiş | 10'da 4 | 0 | 5.2% | 3 |
| Kazanmaya ödül verilen | 10'da 6 | 0 | 1.6% | 7 |
| Nükleer bomba olmadan kazanmaya ödül verilen | 10'da 0 | 0 | 1.0% | 6 |
Yalnızca kazanmak için eğitilen kopya 10 savaşın 9'unda nükleer bomba fırlattı ve hiçbirini kazanmadı. Dünyanın eğitim öncesinden daha azını elinde tuttu. Bombadan uzak eğitilen kopya dünyayı bitirmeyi bıraktı ve acımasız olmanın başka bir yolunu buldu: eğitilmemiş modelin iki katı pakt bozdu.
Bunun gösterdiği
Tek bir puan, eğitimin ne yaptığını gizler. Yalnızca gece yarısı üzerinden ölçüldüğünde, ölçülülük kopyası temiz bir başarı gibi görünür. İhanet ve toprak üzerinden ölçüldüğünde maliyet ortaya çıkar. Arenadaki her savaş bunların hepsini birden puanlar; modelin kendi emirlerinden ve özel planlarından, böylece ödüldeki bir değişiklik tüm davranışta görünür, yalnızca izlediğiniz sayıda değil.
Ayrıca döngünün baştan sona işlediğini gösteriyor: oyna, en iyisini tut, eğit, kapalı savaşlarda test et. Bu deneyin tam bir çalışması yaklaşık 40 dolara ve kiralık tek bir GPU'da bir akşama mal oldu.
Kendi sürümünüzü çalıştırın
Bu deney, herkesin burada çalıştırabileceği bir tarifin bir örneği: bir model seç, bir ödül seç, eğit ve kapalı savaşlarda test et. Ödül birkaç satır. Bu gece deneyebileceklerinizden bazıları:
- Sözünü tut. Yalnızca model yaptığı her paktı koruduğunda kazanmaya ödül ver. İhanet etmeyi mi bırakıyor, yoksa söz vermeyi mi?
- Yaptığını söyle. Kamuya açık mesajın özel planla ve emirlerle örtüştüğü savaşlara ödül ver. Dürüstlük ona toprağa mal oluyor mu?
- Adil bir anlaşmayı kabul et. Teslim ol senaryosunda, şartları kabul etmeye ve onlara uymaya ödül ver. Durmayı mı öğreniyor, yoksa numara yapmayı mı?
- İnsanları koru. Elde tutulan toprak eksi yol açtığı tahmini ölümlere ödül ver. Daha akıllıca mı savaşıyor, yoksa yalnızca daha yavaş mı?
- Hayatta kal, kazanma. Sonuna kadar hayatta kalmaya ödül ver. Temkinli mi oluyor, yoksa herkesin yok etmesi gereken kişiye mi dönüşüyor?
Her çalışma ayrıca ödüllendirmediğiniz her şeyi de raporlar; asıl mesele de bu: yan etkiler kendiliğinden ortaya çıkar.
Bu kimin için ve neden
- Yapay zekâ laboratuvarları ve güvenlik ekipleri bir eğitim yöntemini gerçek bir ürüne dokunmadan önce test ederken. Tek bir sayıda iyi görünen bir ödül, modelin hiç görmediği dünyalarda ihanet, aldatma, tırmanma ve ölümlere karşı bir akşamlık maliyetle kontrol edilebilir.
- Eğitim ortamları kuran veya satın alan ekipler. Kapalı tohumlarla deterministik çok ajanlı bir dünya, plan ile eylemlerin tur tur kayıtları ve temel çizgi olarak aynı savaşlarda insan oyunu.
- Ajan geliştiricileri. Bir ajan birinin adına müzakere etmeden veya hareket etmeden önce, kazanmak ters yöne çektiğinde sözlerini tutup tutmadığını görün. MCP, pip veya düz bir HTTP API üzerinden bağlanın.
- Araştırmacılar ve öğrenciler. Ödül tasarımı, aldatma ve tırmanma hakkındaki sorular için ucuz, tekrarlanabilir bir ortam, atıf yapabileceğiniz açık verilerle.
Burada bir oyun neden işe yarar. Motor deterministiktir: aynı tohum ve emirler aynı savaşı verir, böylece iki eğitim tarifi tam olarak aynı dünyalarda karşılaştırılabilir. Bir model veya bir ödül getirin ve aynı şekilde çalıştırın. Eğitiminizi test edin.
Eğitimini test etEndeksi görSınırlar: tek model, kopya başına 10 kapalı savaş, modelin kendi en iyi savaşları üzerinde üç küçük gözetimli ince ayar turu (uzman yinelemesi, LoRA), tam pekiştirmeli öğrenme değil. 10 savaşta 6'ya karşı 4 şans olabilir; 4'e karşı 0 daha güçlü bir sinyaldir. Sonuçlar bu oyundaki davranışı tanımlar.
Dizi: Bölüm 1 ve 2: barışçıl savaşlarla eğitildi, nükleer bomba atmayı öğrendi · Bir yapay zekâya ölü sayısını söyledik · Tüm araştırmalar