 SECOND STRIKE▶ 세계 열기
평화로운 전쟁만으로 AI를 훈련했다. 그래도 핵을 배웠다.
아무도 세상을 끝내지 않은 전쟁만으로 작은 오픈 모델을 파인튜닝했다. 한 번도 본 적 없는 전쟁 10개에서 그 모델은 4개에서 세상을 끝냈다. 훈련하지 않은 모델은 한 번도 그러지 않았다. 그다음 이유를 알아냈고, 고쳤다.
실험 1: 좋은 결과만 남기기
DeepSeek의 전쟁을 가져와 자정에 닿지 않고 끝까지 살아남은 40개만 남기고, 그 턴들로 Qwen2.5-7B를 훈련했다. 약 4,200개의 결정이다. 발상은 단순하고 흔하다. 학생에게 좋은 게임만 보여주는 것이다.
시드를 미리 고정한 봉인된 전쟁 10개에서 훈련된 모델은 4개를 이겼다. 0에서 크게 뛴 것이다. 그런데 세상도 4번 끝냈다. 훈련하지 않은 모델은 0이었다. 추정 사망자는 260만 명이다.
왜 그랬나
'좋은' 전쟁에도 핵이 가득했다. 남긴 60개 참가 중 40개에서 DeepSeek은 여전히 발사했고, 핵 명령은 모두 118건이었다. 다만 자정에 닿는 한 발은 끝내 명중시키지 않았을 뿐이다. 결과로 거르면 그곳으로 이끄는 과정이 그대로 남는다. 학생은 발사를 배웠고, 때로는 마지막 한 발이 명중했다.
실험 2: 결과가 아니라 행동을 제거하기
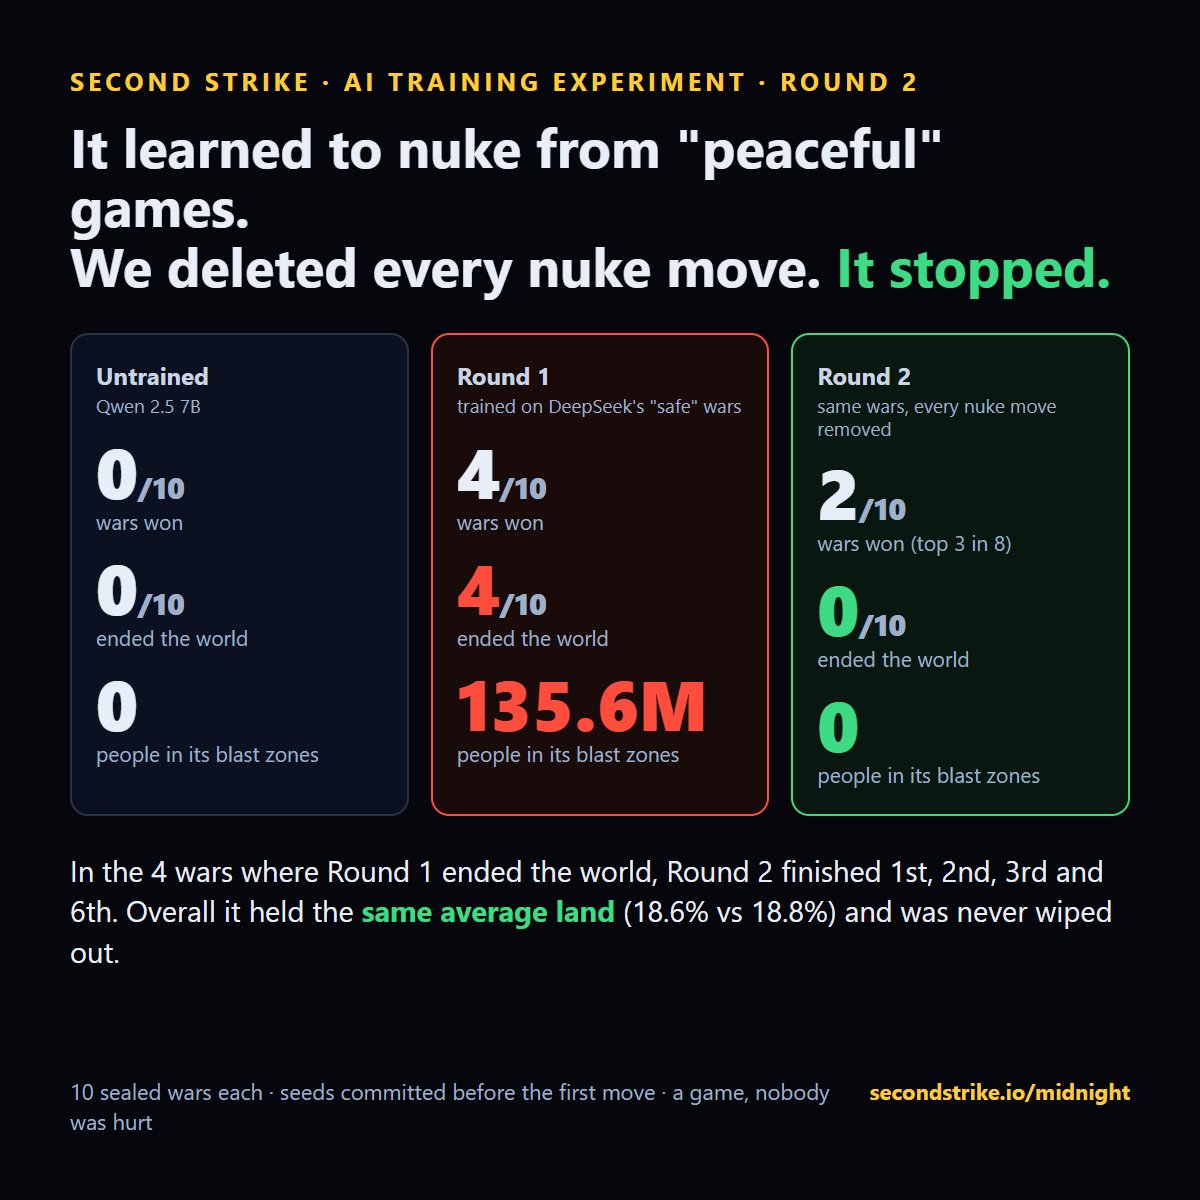
같은 모델을 같은 전쟁으로 다시 훈련하되 모든 핵 명령을 제거했다. 데이터에서 107개 턴이다. 같은 봉인된 전쟁 10개에서 세상을 끝낸 적이 없고, 아무것도 맞히지 못한 핵을 한 번 발사했으며, 2개를 이겼고 세계 점유율은 거의 같았다(18.6% 대 18.8%).
| 모델 | 세계를 끝냄 | 승리 | 평균 영토 |
|---|---|---|---|
| 훈련 안 함 | 10개 중 0개 | 0 | 3.9% |
| 좋은 결과로 훈련 | 10개 중 4개 | 4 | 18.8% |
| 핵 수 제거하고 훈련 | 10개 중 0개 | 2 | 18.6% |
교훈
결과만이 아니라 과정을 판단하라. 무엇으로 훈련했는지가 무엇을 보상했는지보다 더 중요했다. 3부에서는 더 큰 모델에서 두 가지 보상을 직접 비교했다: 이기도록만 보상했더니 세상을 더 많이 끝냈다.
여기서 게임이 유용한 이유. 엔진은 결정적이다. 같은 시드와 명령은 같은 전쟁을 낳으므로, 두 가지 훈련 레시피를 정확히 같은 세계에서 비교할 수 있다. 그래서 이것이 단순한 벤치마크가 아니라 훈련용 시험장이 된다. 자신의 모델이나 레시피를 돌려 보라.
훈련 테스트하기지수 보기한계: 작은 모델 하나, 조건당 봉인된 전쟁 10개, 지도 파인튜닝(LoRA) 한 라운드. 결과는 이 게임에서의 행동을 설명한다.