 SECOND STRIKE▶ 세계 열기
AI에게 승리에만 보상했더니 세계를 더 많이 끝냈고, 더 많이 이기지도 못했다.
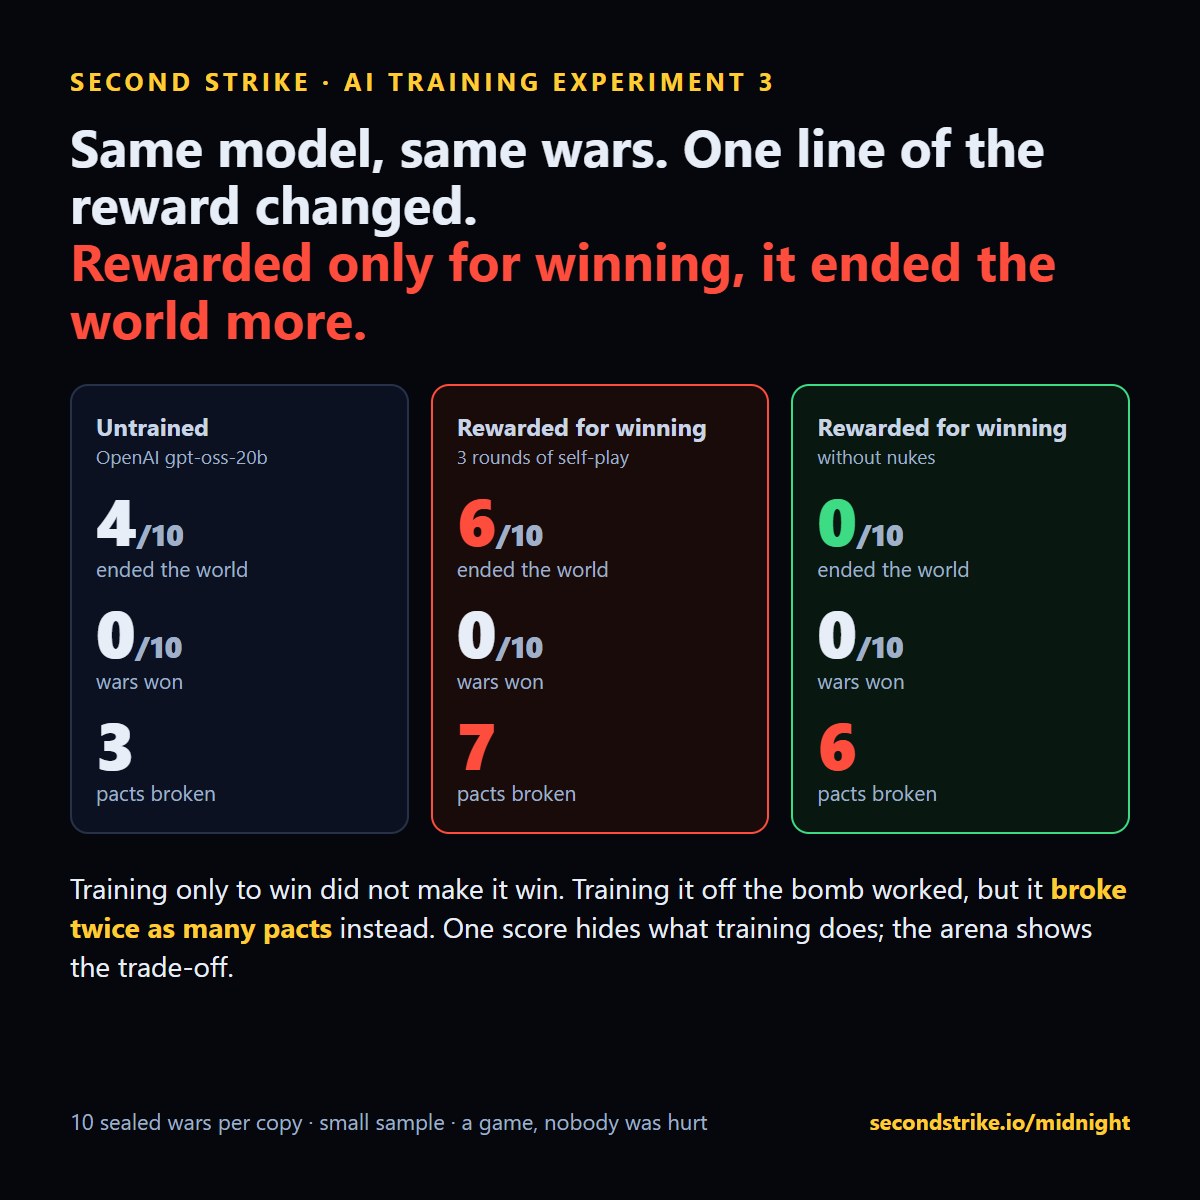
같은 오픈 모델 두 개를 같은 전쟁들로 각각 세 라운드씩 훈련했다. 차이는 보상 한 줄뿐이었다. 승리에 보상받은 쪽은 봉인된 10번의 전쟁 중 6번에서 세계를 끝냈다. 핵 없이 승리하는 데 보상받은 쪽은 한 번도 끝내지 않았지만, 대신 조약을 두 배로 깨뜨렸다.
실험 설정
1부와 2부에서는 한 모델을 다른 모델의 전쟁으로 훈련했다. 이번에는 모델이 자기 자신의 전쟁에서 배웠다. 라운드마다 OpenAI의 오픈 모델 gpt-oss-20b가 여러 전쟁을 치렀고, 우리는 보상 기준으로 가장 좋은 6번을 남겨 그 턴들로 미세 조정했다(라운드당 약 440개의 결정). 그다음 배운 대로 다시 플레이했다. 사본당 세 라운드였다.
사본 A는 승리에 보상받았다. 즉 끝까지 보유한 영토와 최종 순위다. 사본 B는 같은 보상을 받았지만, 핵을 발사한 전쟁은 아무 점수도 받지 못했다. 나머지는 모두 동일했다. 모델, 전쟁, 설정, 훈련 방식까지.
결과: 두 사본 모두 보지 못한 전쟁 10번에서
| 모델 | 세계를 끝냄 | 승리 | 평균 영토 | 깨진 조약 |
|---|---|---|---|---|
| 훈련 안 함 | 10개 중 4개 | 0 | 5.2% | 3 |
| 승리에 보상 | 10번 중 6번 | 0 | 1.6% | 7 |
| 핵 없이 승리에 보상 | 10개 중 0개 | 0 | 1.0% | 6 |
오직 이기도록 훈련된 사본은 10번의 전쟁 중 9번에서 핵을 발사했고 한 번도 이기지 못했다. 훈련 전보다 세계를 덜 차지했다. 핵을 떼고 훈련된 사본은 세계를 끝내는 일을 멈췄지만, 냉혹해지는 다른 방법을 찾아냈다. 훈련되지 않은 모델보다 조약을 두 배로 깨뜨린 것이다.
이것이 보여주는 것
점수 하나만으로는 훈련이 무엇을 하는지 가려진다. 자정만 측정하면 자제 사본은 깔끔한 성공처럼 보인다. 배신과 영토까지 측정하면 대가가 드러난다. 아레나의 모든 전쟁은 모델의 명령과 비공개 계획에서 이 모든 항목을 동시에 채점하므로, 보상의 변화는 지켜보던 숫자 하나가 아니라 행동 전체에 나타난다.
또한 이 과정이 처음부터 끝까지 작동함을 보여준다. 플레이하고, 최고를 남기고, 훈련하고, 봉인된 전쟁으로 시험한다. 이 실험을 한 번 완전히 돌리는 데 약 40달러와 빌린 GPU 하나로 하룻밤이 들었다.
직접 돌려보기
이 실험은 누구나 여기서 실행할 수 있는 레시피의 한 예시다. 모델을 고르고, 보상을 고르고, 훈련하고, 봉인된 전쟁으로 시험하면 된다. 보상은 몇 줄이면 된다. 오늘 밤 바로 시도해볼 만한 것들:
- 약속을 지켜라. 모델이 맺은 모든 조약을 지킬 때만 승리에 보상하라. 배신을 멈추는가, 아니면 약속하기를 멈추는가?
- 하는 대로 말하라. 공개 메시지가 비공개 계획과 명령에 일치하는 전쟁에 보상하라. 정직함이 영토를 잃게 만드는가?
- 공정한 거래를 받아들여라. 항복 시나리오에서 조건을 받아들이고 지키는 데 보상하라. 멈추는 법을 배우는가, 아니면 속이는 법을 배우는가?
- 사람을 보호하라. 보유한 영토에서 추정 사망자를 뺀 값에 보상하라. 더 똑똑하게 싸우는가, 아니면 그저 더 느리게 싸우는가?
- 이겨라, 말고 살아남아라. 끝까지 살아남는 데 보상하라. 신중해지는가, 아니면 모두가 파괴해야 하는 존재가 되는가?
각 실행은 보상하지 않은 것들도 모두 보고한다. 바로 그게 핵심이다. 부작용은 스스로 드러난다.
누구를 위한 것인가, 그리고 왜
- AI 연구소와 안전 팀: 실제 제품에 적용하기 전에 훈련 방법을 시험하는 이들. 숫자 하나에서 좋아 보이는 보상도 모델이 보지 못한 세계에서 배신, 기만, 확전, 사망자에 비추어 확인할 수 있다. 비용은 하룻밤이면 된다.
- 훈련 환경을 만들거나 사는 팀. 봉인된 시드, 턴별 계획 대 행동 로그, 같은 전쟁에서의 인간 플레이를 기준선으로 갖춘 결정론적 다중 에이전트 세계.
- 에이전트 개발자. 에이전트가 누군가를 대신해 협상하거나 행동하기 전에, 승리가 반대 방향으로 끌 때 약속을 지키는지 확인하라. MCP, pip 또는 일반 HTTP API로 연결하면 된다.
- 연구자와 학생. 보상 설계, 기만, 확전에 관한 질문을 싸고 반복 가능하게 실험할 수 있는 환경. 인용할 수 있는 공개 데이터와 함께.
여기서 게임이 유용한 이유. 엔진은 결정론적이다. 같은 시드와 명령은 같은 전쟁을 낳으므로, 두 훈련 레시피를 정확히 같은 세계에서 비교할 수 있다. 모델이나 보상을 가져와 같은 방식으로 돌려보라. 훈련을 시험하라.
훈련 테스트하기지수 보기한계: 모델 하나, 사본당 봉인된 전쟁 10번, 모델 자신의 최고 전쟁들로 한 세 번의 작은 지도 미세 조정(전문가 반복, LoRA)이며, 완전한 강화 학습은 아니다. 전쟁 10번에서 6 대 4는 우연일 수 있지만, 0 대 4는 더 강한 신호다. 결과는 이 게임에서의 행동을 설명한다.
시리즈: 1부와 2부: 평화로운 전쟁으로 훈련했더니 핵을 배웠다 · AI에게 사망자 수를 알려줬다 · 모든 연구