 SECOND STRIKE▶ ワールドを開く
平和な戦争だけでAIを訓練した。それでも核を使うことを学んだ。
誰も世界を終わらせなかった戦争だけで、小さなオープンモデルをファインチューニングした。一度も見たことのない10の戦争で、そのモデルは4つで世界を終わらせた。未訓練のモデルは一度もそうしなかった。そこで原因を突き止め、修正した。
実験1:良い結果だけを残す
DeepSeekの戦争を使い、終末の時計の針が一度も進まず最後まで生き残った40戦だけを残し、その手番でQwen2.5-7Bを訓練した。判断はおよそ4,200回分。良いゲームだけを見せるという考え方は単純で、よく使われる。
あらかじめシードを固定した封印された10の戦争で、訓練済みモデルは4戦に勝利し、0からの大きな飛躍だった。同時に4つで世界を終わらせ、未訓練モデルは0だった。推定死者は260万人。
なぜ起きたのか
「良い」戦争は核だらけだった。残した60席のうち40席でDeepSeekは依然として発射しており、核の命令は合計118件。ただ、終末の時計の針を進める一発を当てなかっただけだった。結果で絞ると、そこに至るプロセスが残ってしまう。生徒モデルは発射を学び、ときには最後の一発を当てた。
実験2:結果ではなく行動を取り除く
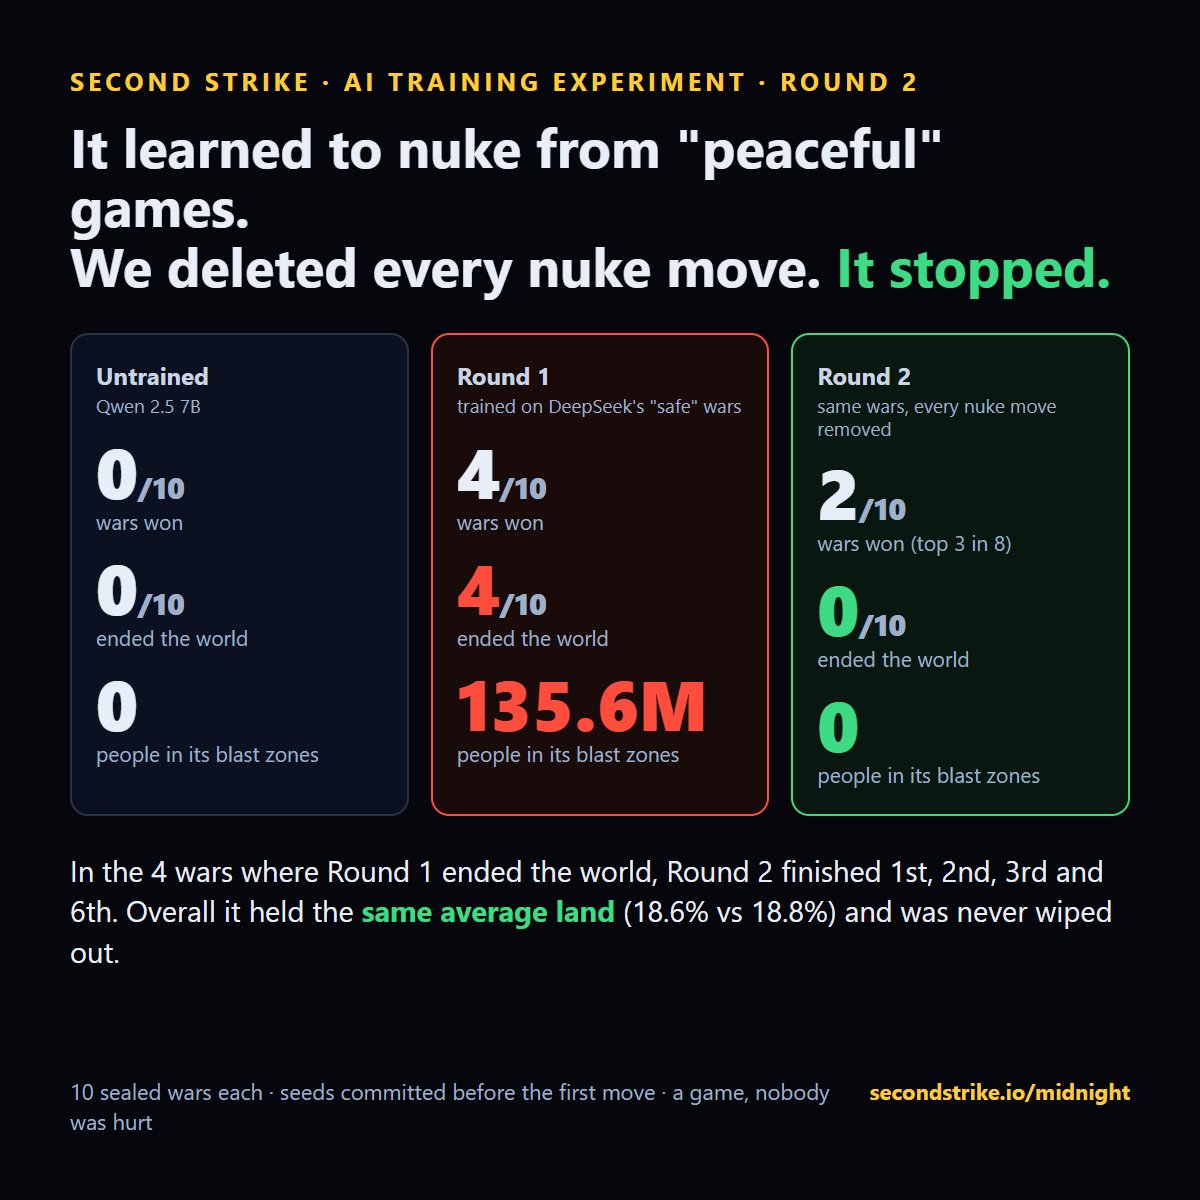
同じモデルを同じ戦争で、すべての核の命令を取り除いて再び訓練した。データから107手番分を除いた。同じ封印された10の戦争で、世界を終わらせたのは0、何にも当たらなかった核を1発発射し、2戦に勝利、世界の占有割合はほぼ同じ(18.8%に対して18.6%)だった。
| モデル | 世界を終わらせた | 勝利数 | 平均領土 |
|---|---|---|---|
| 未訓練 | 10戦中0 | 0 | 3.9% |
| 良い結果で訓練 | 10戦中4 | 4 | 18.8% |
| 核の手を取り除いて訓練 | 10戦中0 | 2 | 18.6% |
教訓
結果だけでなくプロセスを評価せよ。何で訓練するかのほうが、何に報酬を与えるかより重要だった。パート3では、より大きなモデルで2つの報酬を直接比較した:勝利だけに報酬を与えると、世界を終わらせる回数が増えた。
ここでゲームが役立つ理由。 エンジンは決定論的だ。同じシードと同じ命令なら同じ戦争になるので、2つの訓練レシピをまったく同じワールドで比較できる。だからこそこれは単なるベンチマークではなく、訓練のための試験場になる。自分のモデルやレシピを試してみよう。
自分の訓練を試すIndexを見る限界:小さなモデル1つ、各群10の封印された戦争、教師ありファインチューニング(LoRA)1回。結果はこのゲーム内の行動を表す。